- 移动端

上海中科新生命生物科技有限公司
18 年
手机商铺
- NaN
- 0
- 0
- 1
- 0
公司新闻/正文
队列专题 | 同一套指标,换个中心就不灵?聊聊队列研究里的“中心效应”
15 人阅读发布时间:2026-11-06 21:28
APTBIO
队列专题
现在做临床研究,很多团队都会往“多中心”上靠。道理很简单:一个中心收的病人有限,人群也窄,结论外推到别的地方心里没底;多几家医院一起收样,样本量上来了,人群也杂了、更贴近“真实世界”。
但麻烦也出在“多中心合在一起”这一步,把几家医院的数据并到一张分析表里,可能会撞见一件怪事:同样的疾病、同样的标志物、甚至同一套检测流程,算出来的结果却自说自话,有的中心显著,有的中心压根不显著;模型在一家医院跑得漂亮,换个地方就失效了。
我们这篇文章想把这背后的“中心效应”讲清楚:它是什么、从哪来、怎么在设计和分析阶段把它压下去,以及投稿前该自查哪几件事。这几年 AI 预后模型、组学标志物正热,可不少团队第一次正面撞上中心效应,都是在跨中心队列验证时模型突然“失灵”的那一刻。这不是数据不够多,而是差异没被正视、没被控制。
一个直观的例子:今年发表在Nature Medicine上的一项研究,联合了六国六中心、共 2396 名晚期非小细胞肺癌患者,用常规临床和血液数据建了一个 AI 预后模型。模型在自己内部测试集上 AUC 达到 0.77,可一到外部验证中心,AUC 就掉到了 0.55–0.72。作者把这种衰减,归到了各中心患者选择、疾病严重度、随访实践的差异上。这就是中心效应导致模型跨中心失效的典型一例,也顺带说清了一件事:外部验证和重新校准,不是可选项。
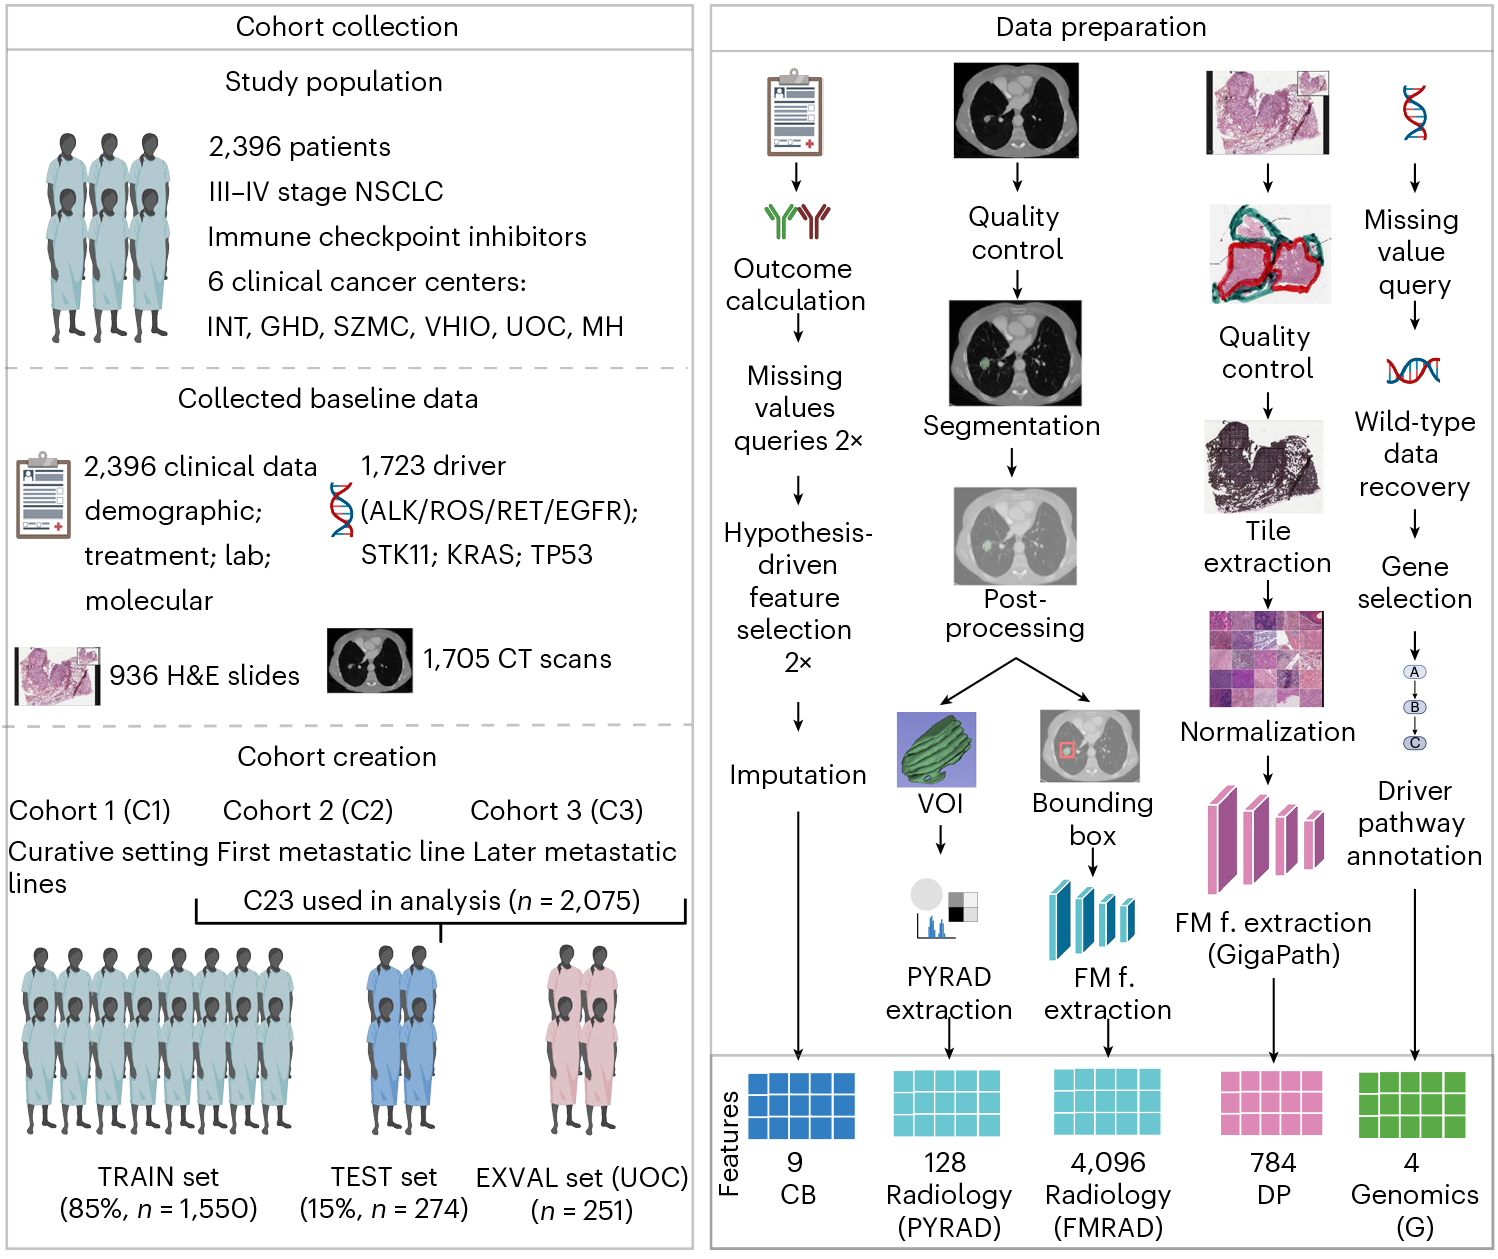
图1 Ai模型辅助构建多中心医院小细胞肺癌预后模型
一、中心效应到底是什么?
说白了,中心效应就是:在不同研究中心之间,因为试验条件、受试者特征或者操作上的差异,导致各中心的结果出现了系统性的偏差。它本质上是一种偏倚,也是一种异质性来源——会同时拖累结果的准确性和可外推性,假阳性也会跟着往上走。
它基本绕不开三个来源:人群基线差异、操作差异、测量差异。
受试者差异
各中心入组人群的年龄、病情严重程度、合并症比例、地域人种等基线特征对不上。
入组不均衡
各中心入组例数差太多,例数少的中心结果不稳定,容易把整体趋势带偏,最后合并出来的多中心结论也就不可靠。
操作与评估差异
不同中心研究者的熟练度、随访依从性、数据记录质量参差不齐;像量表评分、影像判读这种主观性强的指标,各家标准不统一。
检测与设备差异
实验室方法、仪器校准、单位不统一,或者有的中心用本地实验室而非中心实验室,检测标准和结果自然有偏差。
二、容易误判的情况:把测量差异当成“批次效应”
上面三类里,测量差异最容易被忽略。用不同平台和试剂做检测后,PCA 图上体现出的差异,研究者多半会先扣上“批次效应”的帽子。
这里有个区分的关键。Gelman 和 Hill 在 2006 年那本回归与多层模型教材里,就“中心效应”和“批次效应”给过一套理论框架:给每个中心建随机截距、随机斜率,组成混合效应模型(mixed-effect)。全体人群共享固定效应(fixed effect),每个中心各自带一段偏移,那就是随机效应(random effect)。随机截距给每个中心一个基线偏移,随机斜率则允许“差异本身”在各中心也略有不同。混合效应模型的好处,是它承认中心之间存在差异,再用模型去处理,而不是一刀切地当成技术问题抹掉。
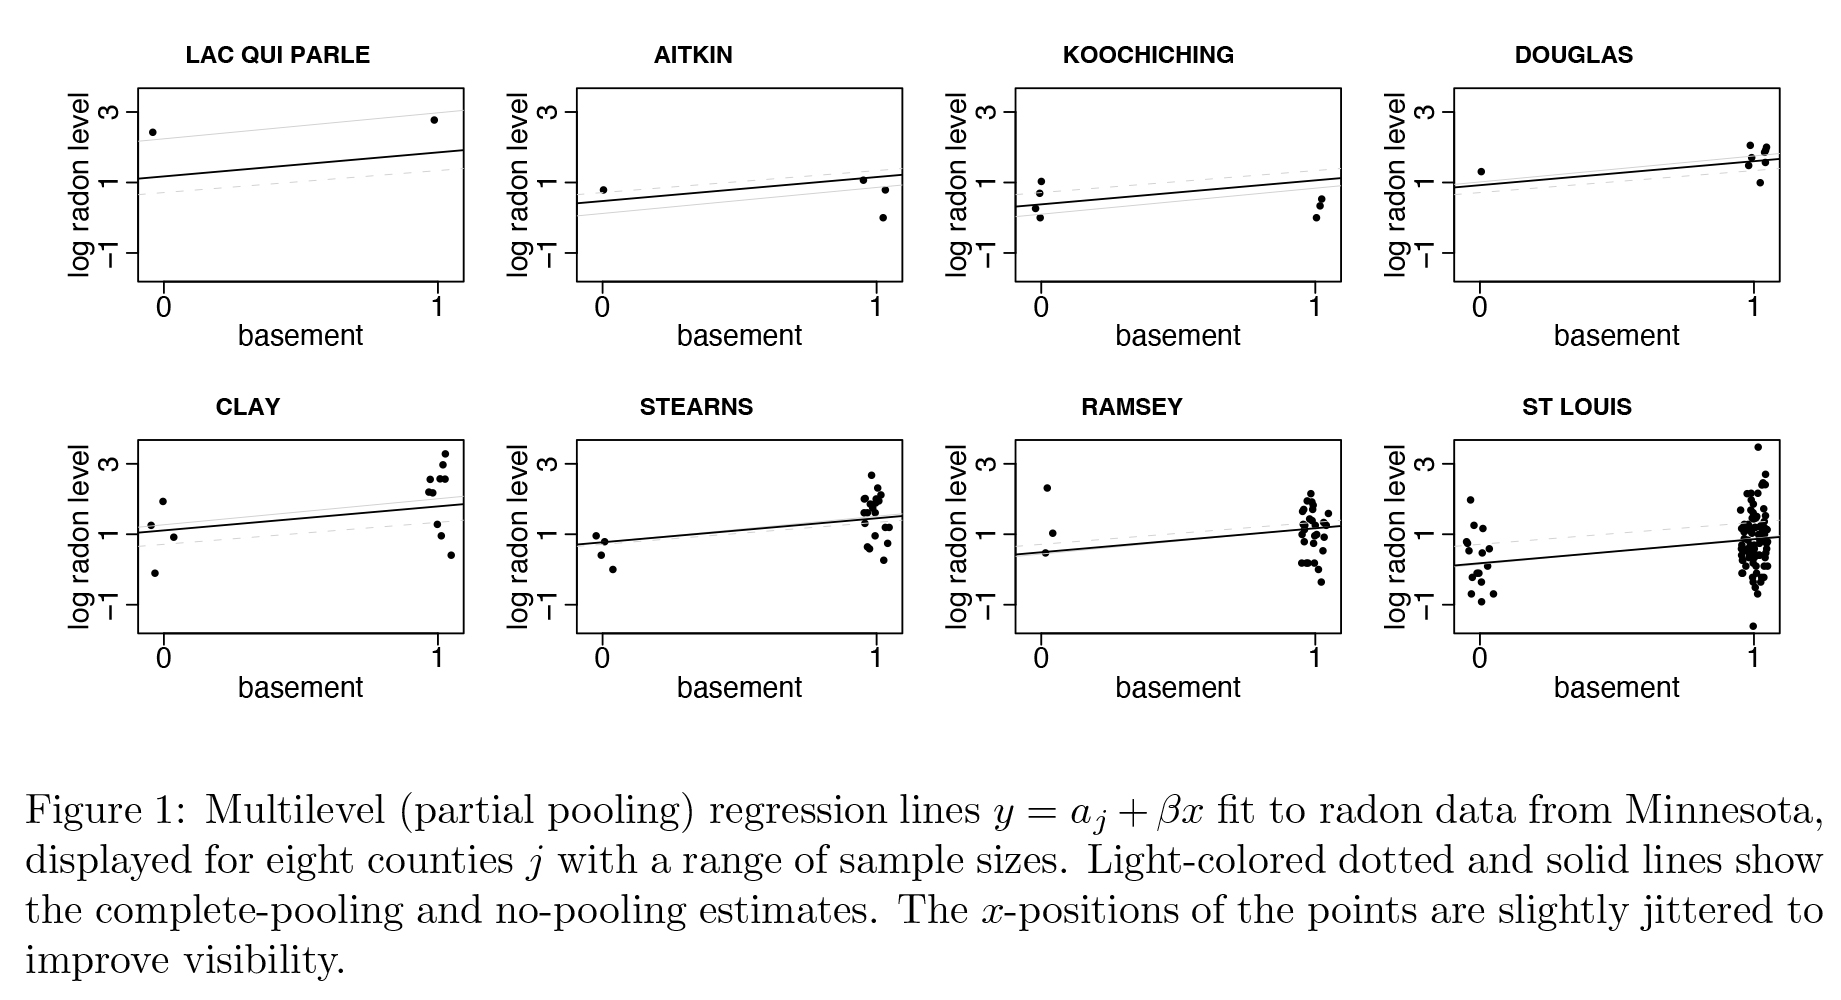
图2 斜率截距模型构建
三、从源头控制:设计和前期该干什么?
针对上面这些来源,做多中心队列项目时,临床侧能做的,是先尽量把各地的诊断、收样、保存、运输标准统一成同一份 protocol。组学检测正式开始之前,还得把样本随机化的问题想清楚:各中心内部做区组随机化,把病例/对照、各个时点,随机散布到各机各批。这一步的关键动作之一是记好排机表——blank 样本、QC 样本、正式样本,分别排在哪个机、哪一批,都得留痕。
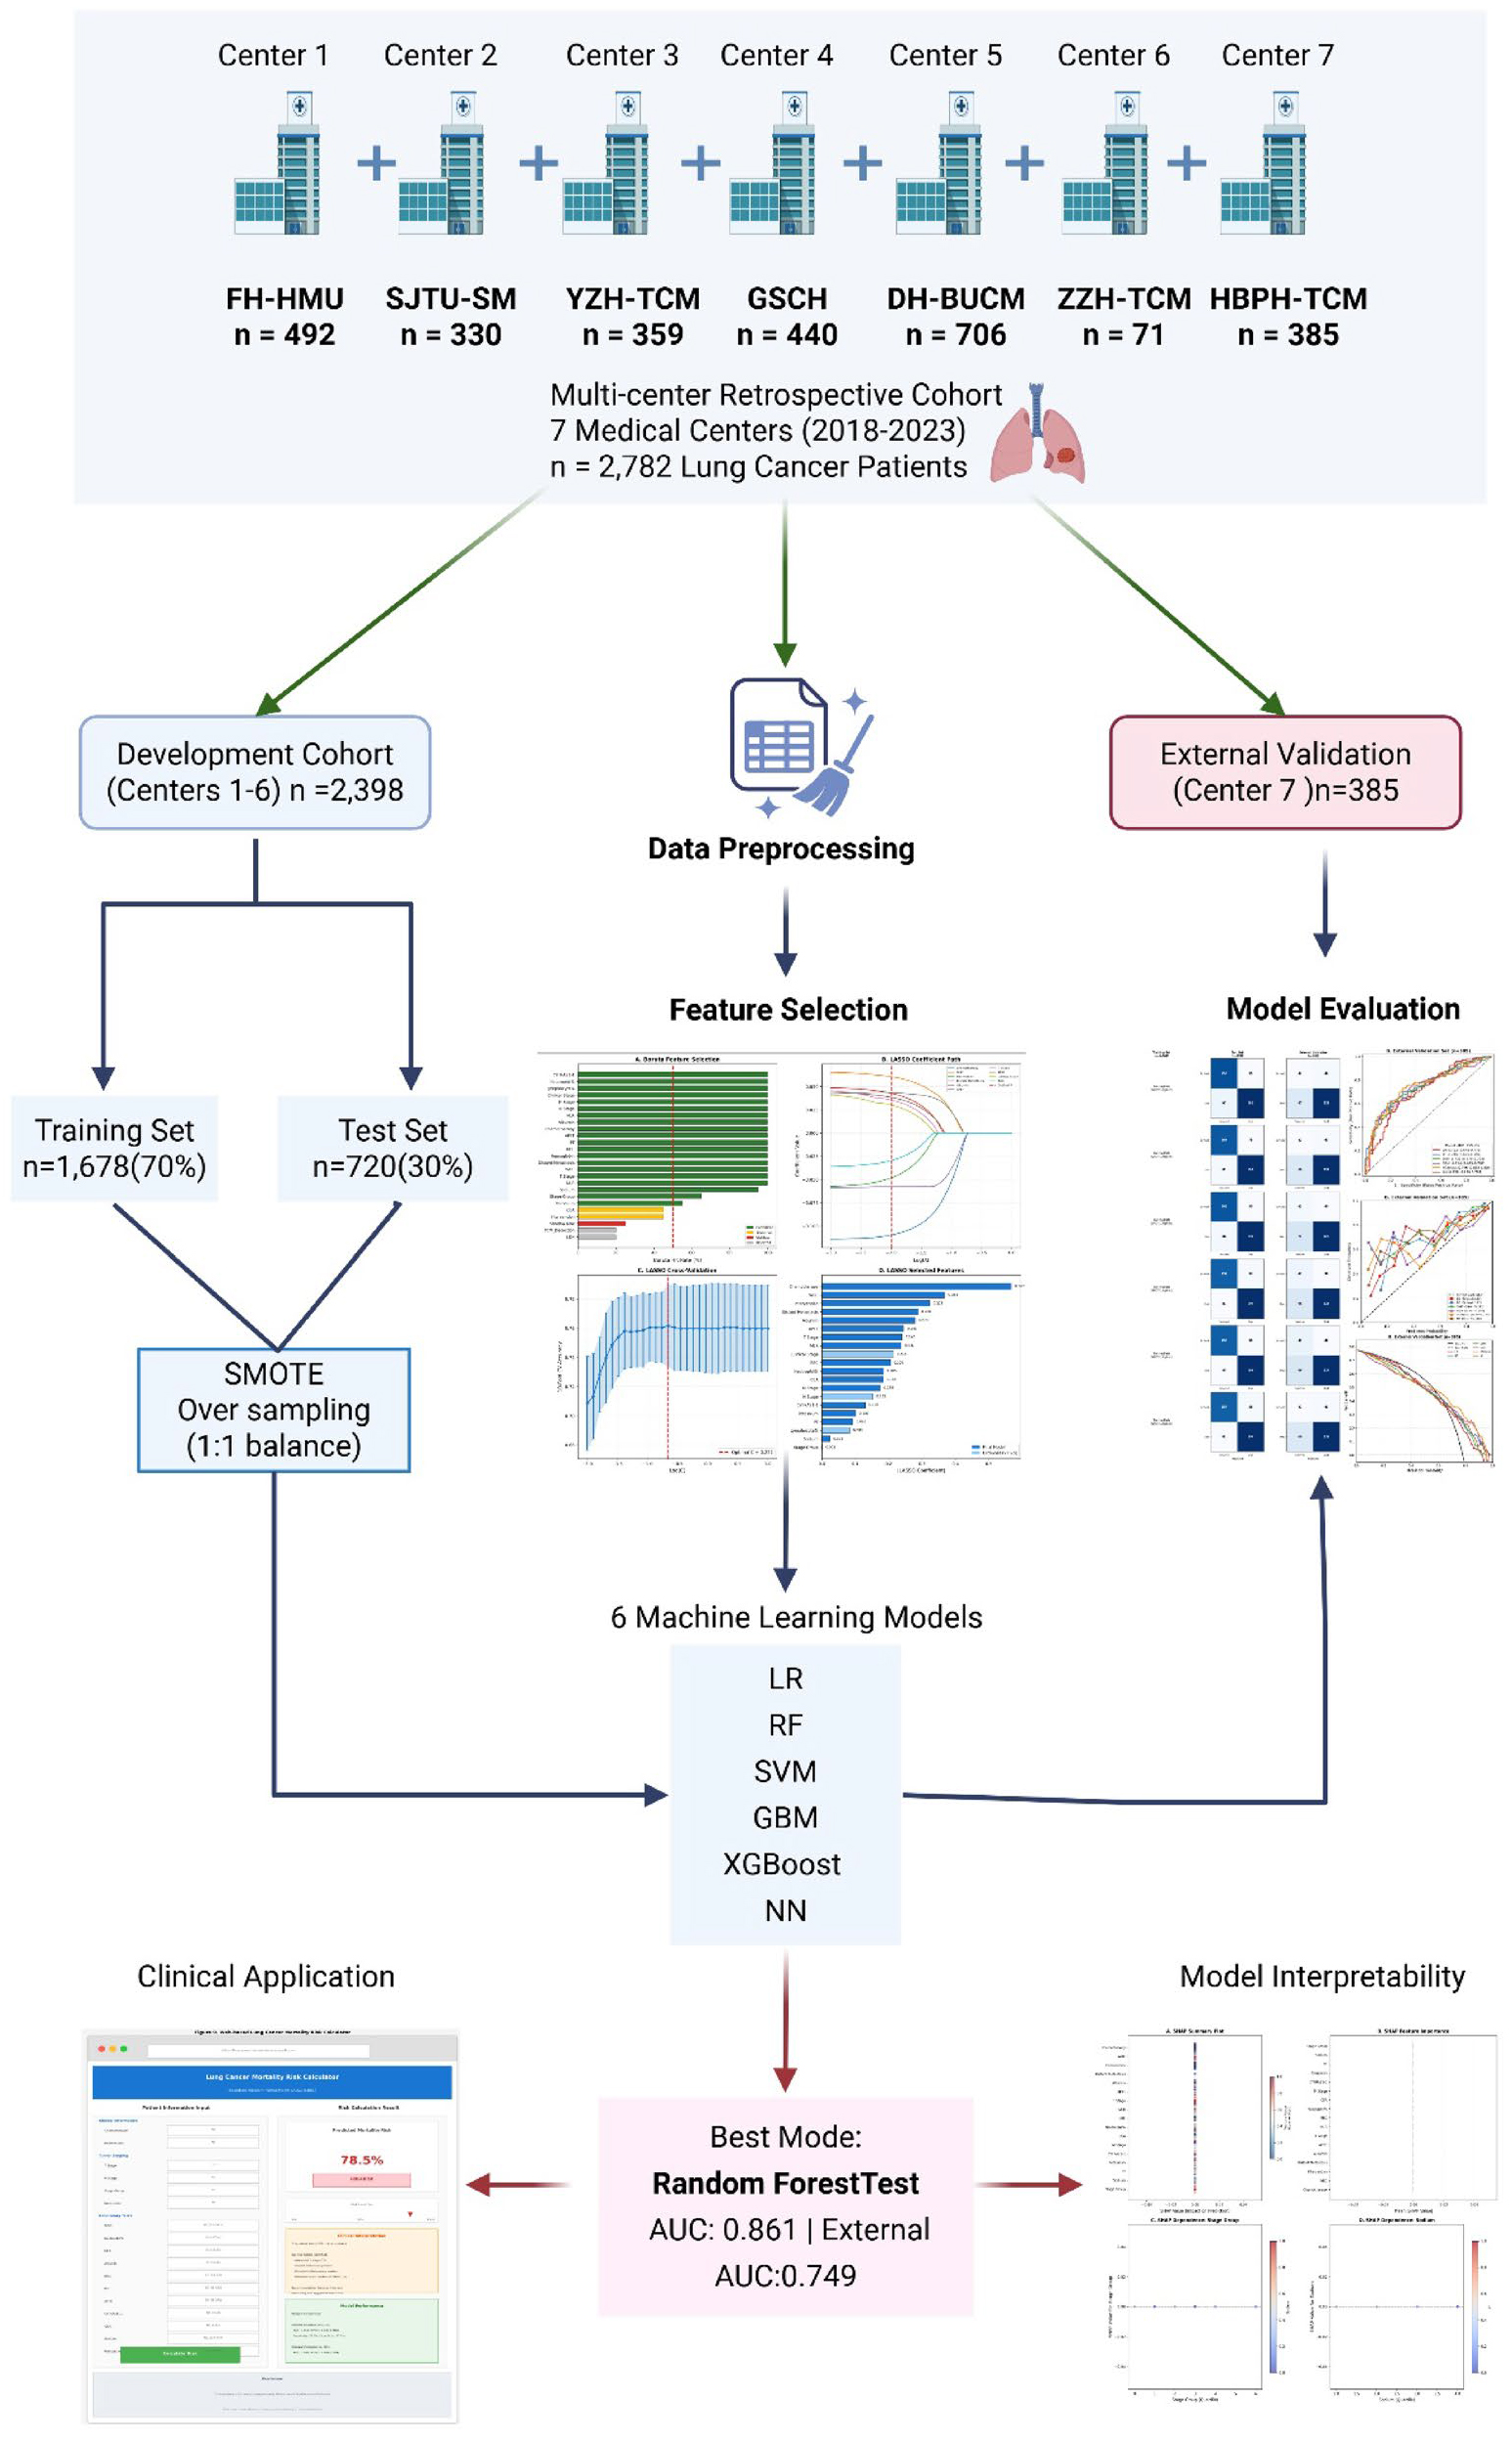
图3 多中心医院肺癌标志物流程图
四、拿什么盯住漂移——跨中心穿插 QC pool
给待检测样本加上能用于批次矫正的质量 QC,或者在多批次样本里掺入用于桥接的样本,检测结束后再做数据矫正,这是常规操作。更实用的一招,是跨中心穿插 QC pool(合并质控池):把同一个 pool 的样本打散,分到各中心、各批、各机上去测,看检测值稳不稳。它一旦漂移,基本就能定位到是某中心某批出了问题。
具体做法:从所有入组样本里各取等体积,混成一个“池”,分装成多份,随机插进每个中心、每批、每台机器。得说清楚,QC pool 不是“标准品”,它的角色是“过程控制”——盯的是整个检测流程稳不稳定,而不是给浓度当绝对参考。实际检测里,一般每隔 20–40 个样本就插一针 QC pool;在蛋白组,QC pool 跨批 CV 要压到 15% 以内,代谢组则控制在 20% 以内。
五、数据出来后怎么矫正——常见批次合并算法
到了数据层面,可以用算法做批次合并。常见的批次矫正算法有 ComBat、EigenMS、SVR(support vector regression)等,靠批次间的 QC,把两批相对离散的样本拟合到一起。
用这类方法做批次间合并时,有几个坑得提前避开:方案设计阶段就要规划好,保证前后检测是同一实验条件;多批次样本得用同样的 QC,这样才能做批次效应考察和矫正分析;另外数据分析时,查库软件和条件保持一致,前一批数据和新一批数据,建议同时重新查库。
表1 文章中使用不同机器学习算法进行的AUC计算
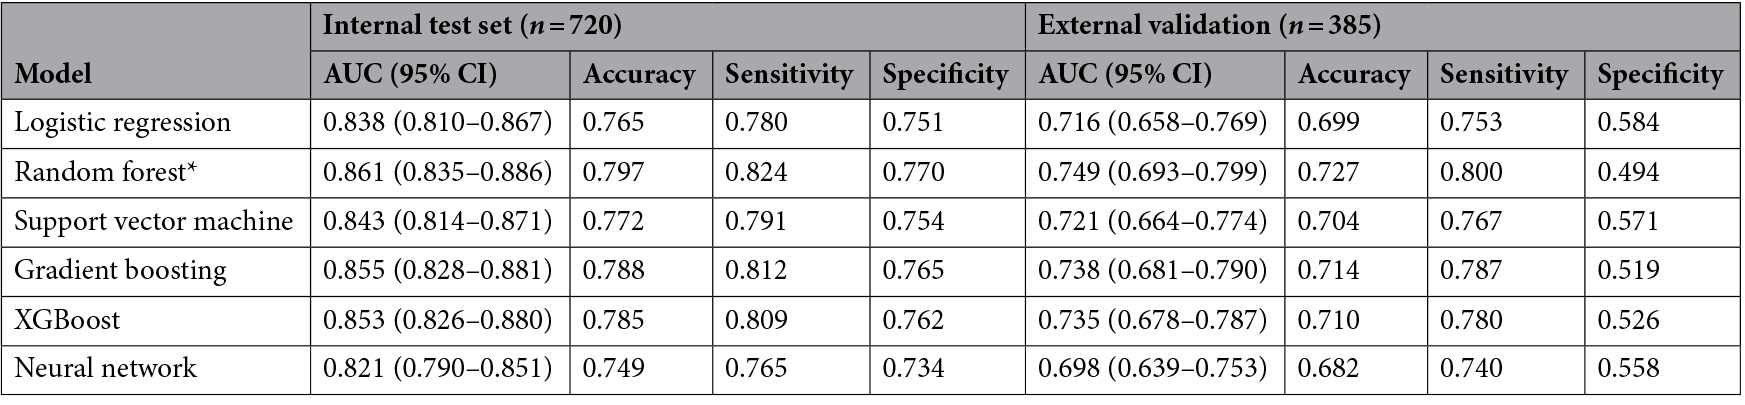
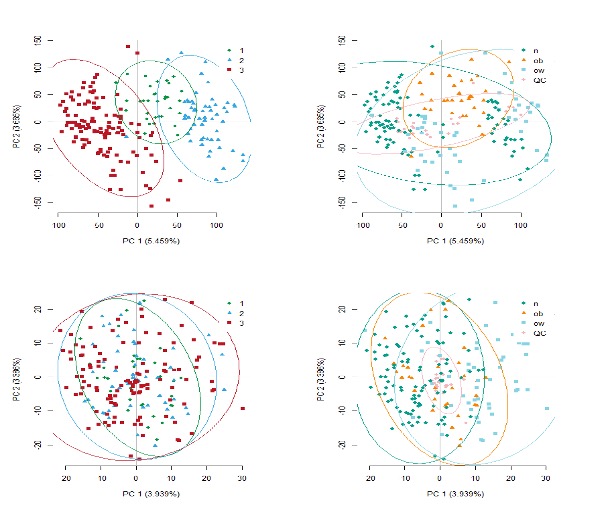
图4 我司通过算法进行批次矫正的实际案例
六、别忽视合规:协议注册与伦理
多中心课题启动前,协议要在对应的 registry 登记(国内可在中国临床试验注册中心 chictr.org.cn),各中心的伦理批件一个都不能少。现在审稿人常会要求附上注册号;多中心的知情同意也得用统一模板,各中心表述不一致,一样会被质疑。
七、文章投稿前,用这五条自查一遍:
1. 中心间操作 SOP 是否一字不差?尤其是采血、冻存、转运三段。
2. center 在模型里是当固定效应还是随机效应?顶刊默认是随机。
3. QC pool 跨中心的 CV 控制在多少?通常 15% 以内是底线。
4. 排机表是否准确记录?可考虑附在 supplementary。
5. 协议注册号和伦理批件齐不齐?缺一个就会返修。
参考文献
[1] Prelaj A, Miskovic V, Sacco M, et al. Clinical usability of an explainable AI decision support tool and evaluation of multimodal models in NSCLC. Nat Med. 2026 Sep;32(9):3235-3247. doi: 10.1038/s41591-026-04488-2. Epub 2026 Sep 13. PMID: 42733093; PMCID: PMC13577906.
[2] Gelman, A., & Hill, J. Data analysis using regression and multilevel/hierarchical models. Cambridge University Press. (2006). ISBN:9780511266836
[3] Liu, L., Zuo, P., Yu, C. et al. Development and external validation of machine learning models for predicting mortality in patients with lung cancer: a multicenter retrospective cohort study. Sci Rep 16, 33532 (2026).
中科优品推荐
【中科新生命】的多组学服务业务可为各位研究者提供详细的“实验设计、样本检测、生信分析、数据解读与挖掘”等工作,为您深入进行科学研究,发表高分文章,为后续临床转化奠定基础。
关于中科新生命
上海中科新生命生物科技有限公司(APTBIO)创立于 2004 年,由原中国科学院上海生命科学研究院蛋白质组研究中心孵化而来,是国内质谱多组学应用领域的开拓者。公司以 “AI + 质谱多组学” 双核驱动创新,构建智能化组学生态。拥有自主知识产权的质谱检测平台与 AI 大数据分析系统,聚焦科技服务、生物医药及大健康消费三大领域,为全球科研机构、医院、药企提供从基础研究到临床转化的一站式解决方案。融合多组学技术与人工智能,围绕生物标志物发掘、药物靶点筛选及个性化诊疗等方向,构建具有国际竞争力的组学数据库与算法模型,推动转化医学进程,加速创新药物研发,成为推动生命科学数字化升级的核心引领者。