- 移动端

上海中科新生命生物科技有限公司
18 年
手机商铺
- NaN
- 0
- 0
- 1
- 0
公司新闻/正文
血液蛋白质组学没有最优平台,只有最适配方案——四大平台的分工与选型逻辑
0 人阅读发布时间:2026-11-03 11:10
APTBIO
蛋白专题
血液是临床与转化研究里最容易拿到的样本,也是蛋白质组学最难做的体系之一:白蛋白、免疫球蛋白、转铁蛋白等十几种高丰度蛋白占去血浆总蛋白九成以上,细胞因子、组织渗漏蛋白和低丰度候选标志物全埋在剩下不到一成里。选平台,本质是选一套对付动态范围的策略。
选错的代价很具体:大队列的钱花了,才发现目标蛋白不在 panel 里;样本冻了十年只剩 20 μL,上机才被告知某平台一次要 55 μL;该做无偏发现的阶段买了靶向验证工具。下面按“先给结论、再讲依据”展开:先放一张速查表方便对着自己的项目定位,再看近三年顶刊和大队列把四个平台用在了哪里,然后逐平台拆解,最后做场景化选型。
速查表:四平台画像一览
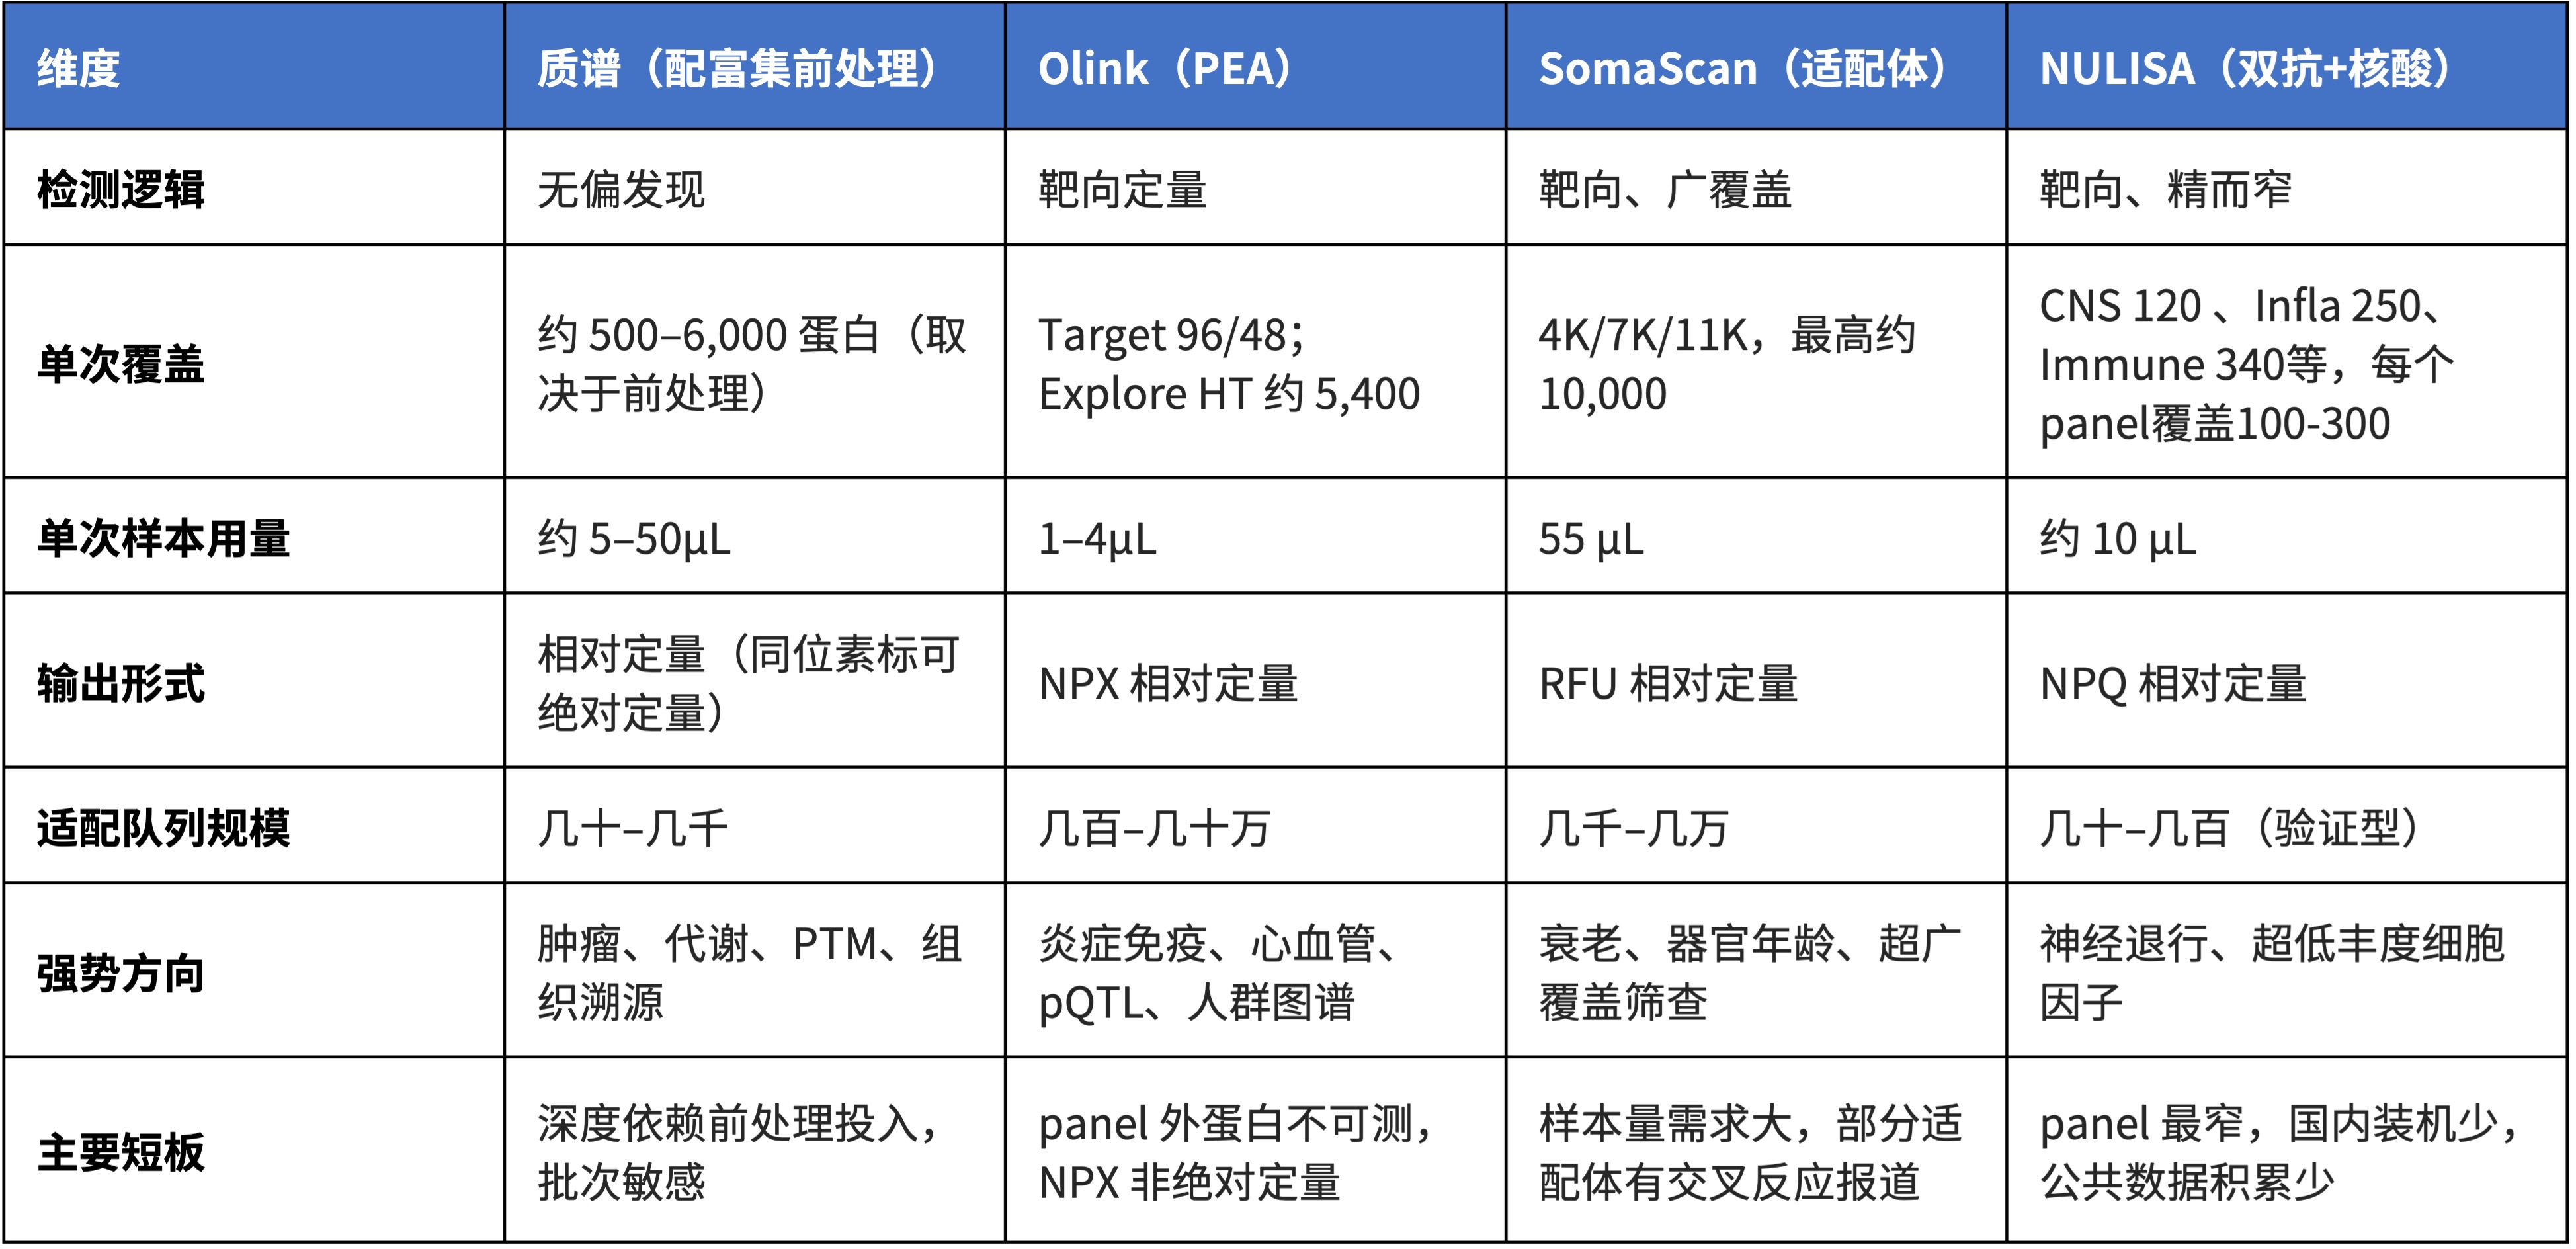
图1 四平台画像速查表
一、先看顶刊和大队列在用什么
下表筛选了 2024—2026 年发表于 Nature、Science、Cell 正刊,以血浆/血清蛋白质组学为核心研究手段的代表性文献。
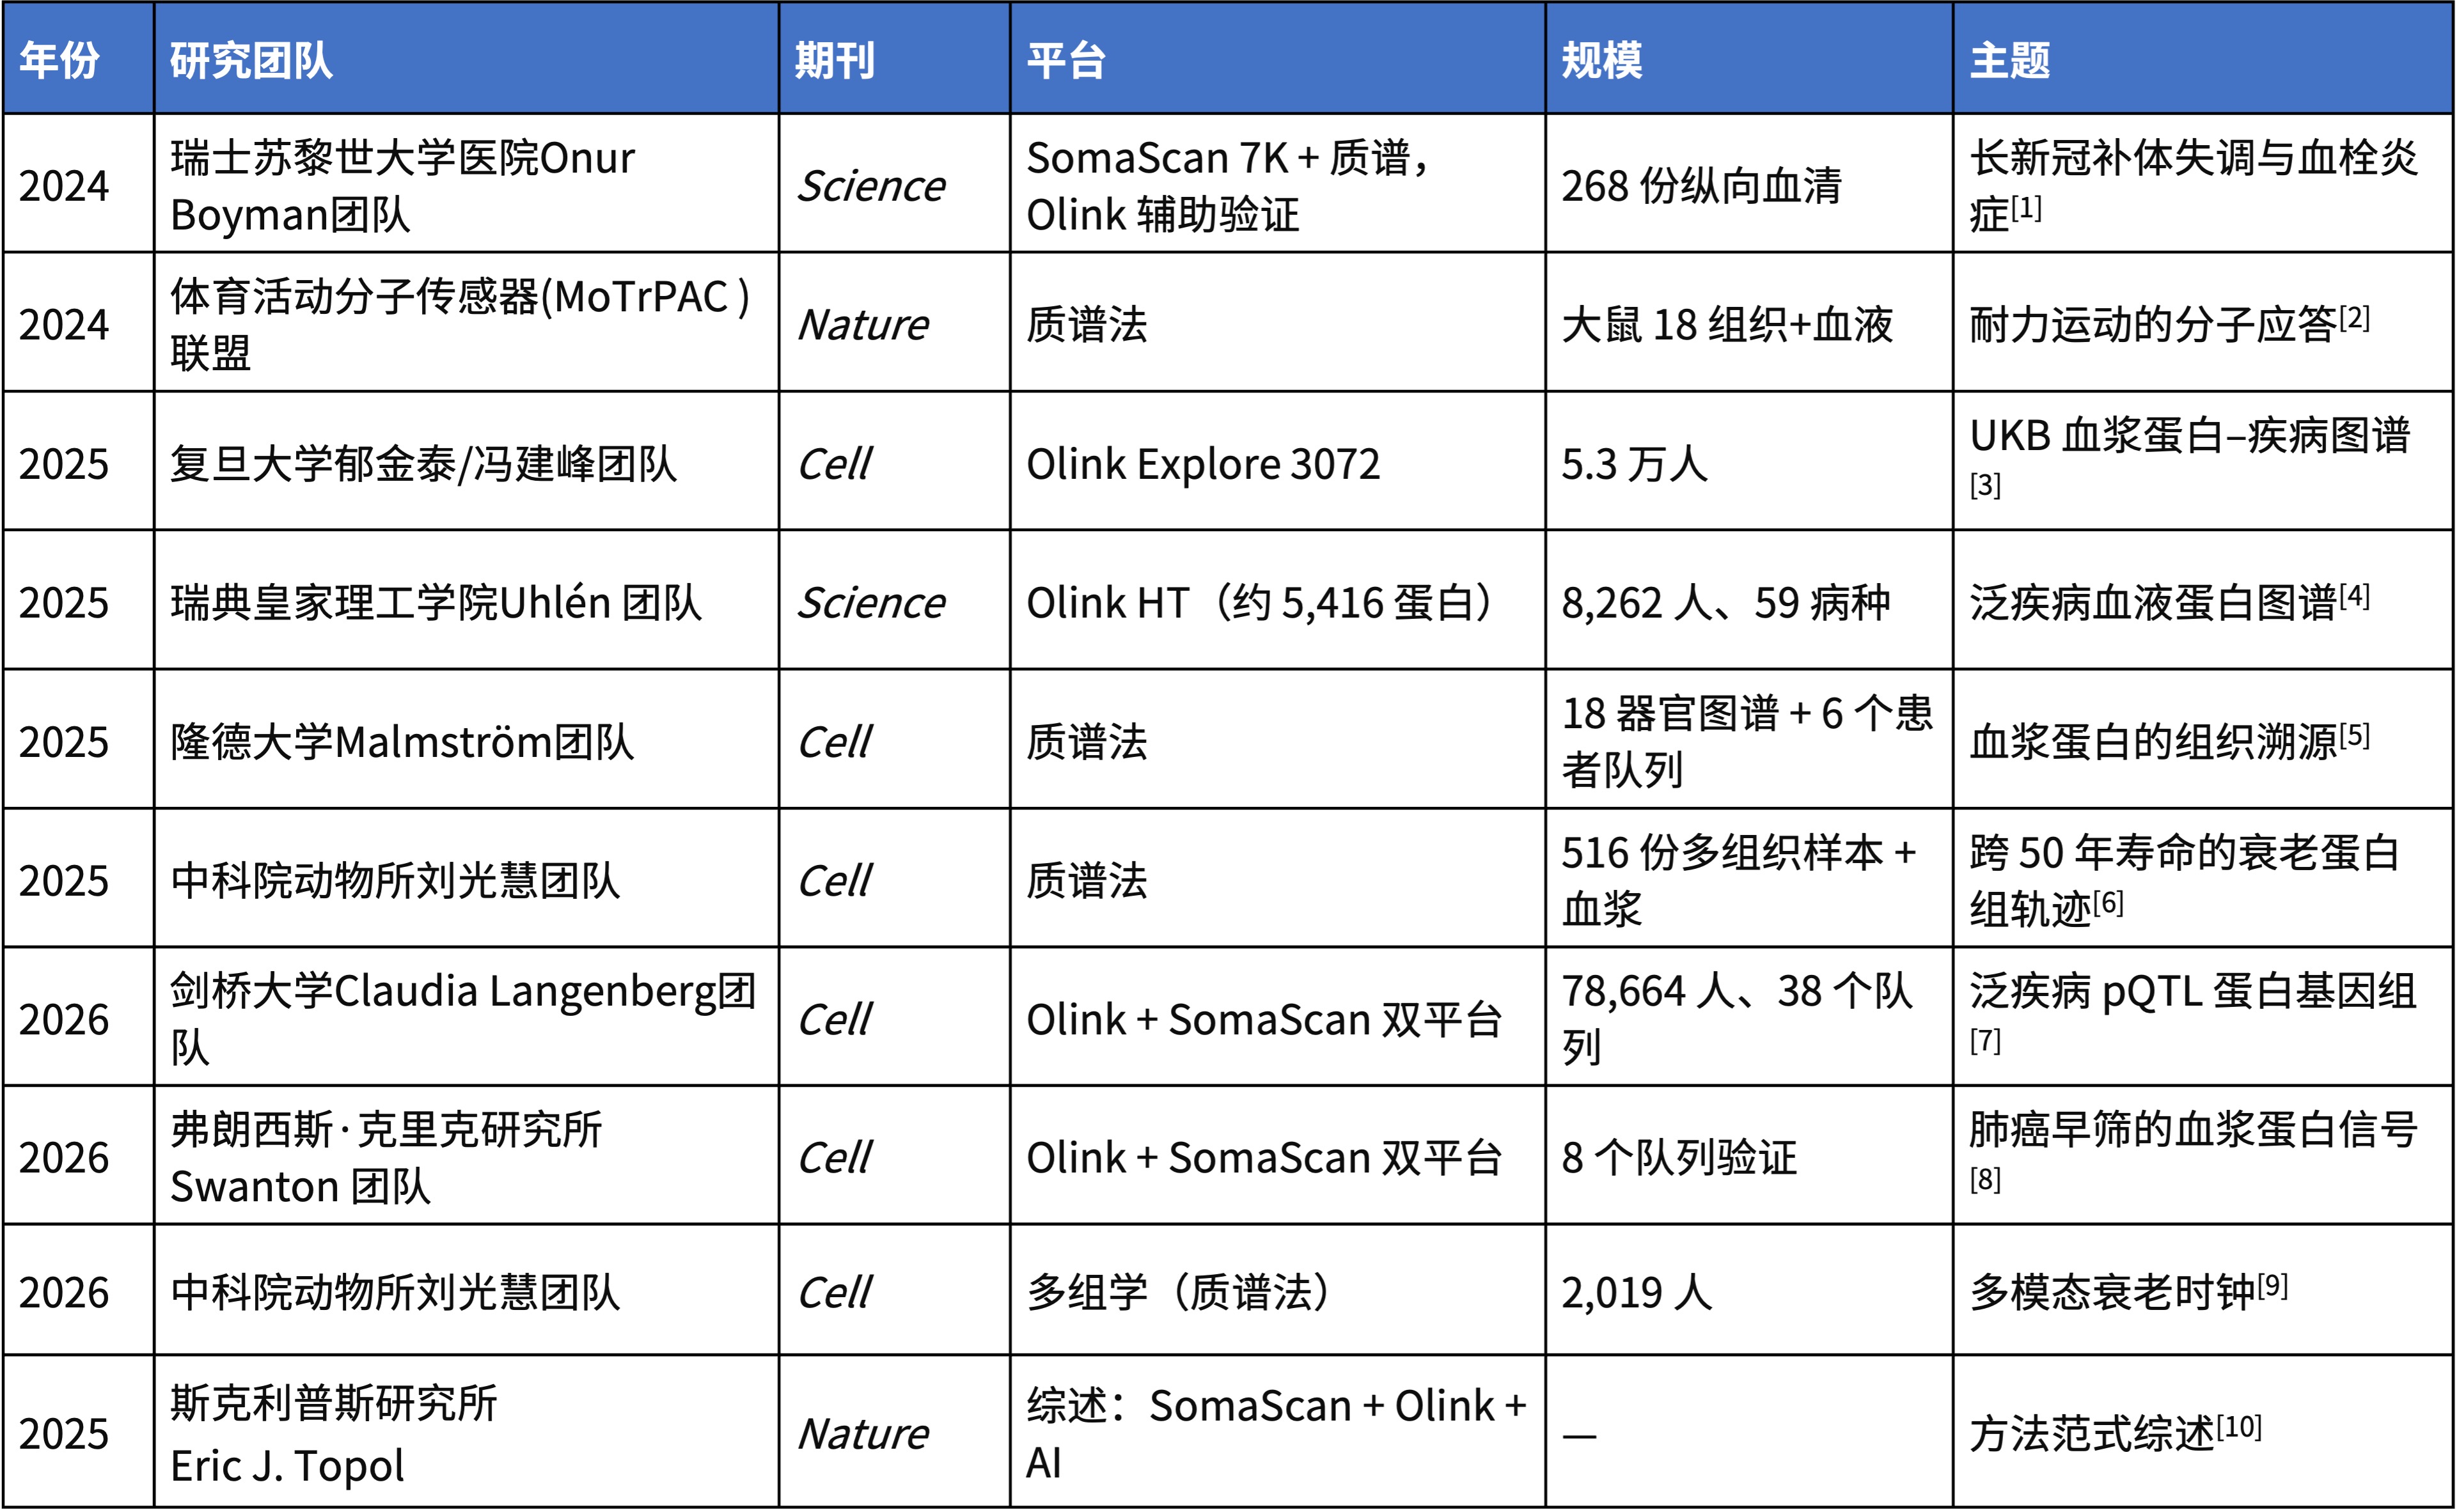
图2 血浆/血清蛋白质组学顶刊研究一览(2024—2026)
二、逐平台拆解
(一)质谱:深度取决于你肯在前处理上花多少
无偏是它的核心优势:不预设靶标,样本里有什么原则上就能测到什么。但血浆直接上机,信号会被高丰度蛋白压制,能看多深基本由前处理决定。
抗体亲和去除(Agilent MARS Human-14、Thermo High Select 14 种高丰度蛋白去除柱):成本最低、兼容 DDA/DIA,深度通常1000-2500蛋白。它只做“减法”,可能连带去掉与白蛋白结合的低丰度蛋白。
肽配体库均衡富集(Bio-Rad ProteoMiner):六肽微球让高丰度蛋白在有限位点饱和、低丰度相对富集,从而压缩动态范围。流程复杂、批间重复性需严控,且原始相对定量关系被改变,不适合要求保留天然定量信息的比较研究。
功能化纳米颗粒富集(如 Seer Proteograph):蛋白冠选择性富集低丰度组分,配 dia-PASEF 等高分辨质谱,深度可达 3000-6000 蛋白组,是目前最深且可自动化放量的方案;成本和机时明显高于抗体去除。
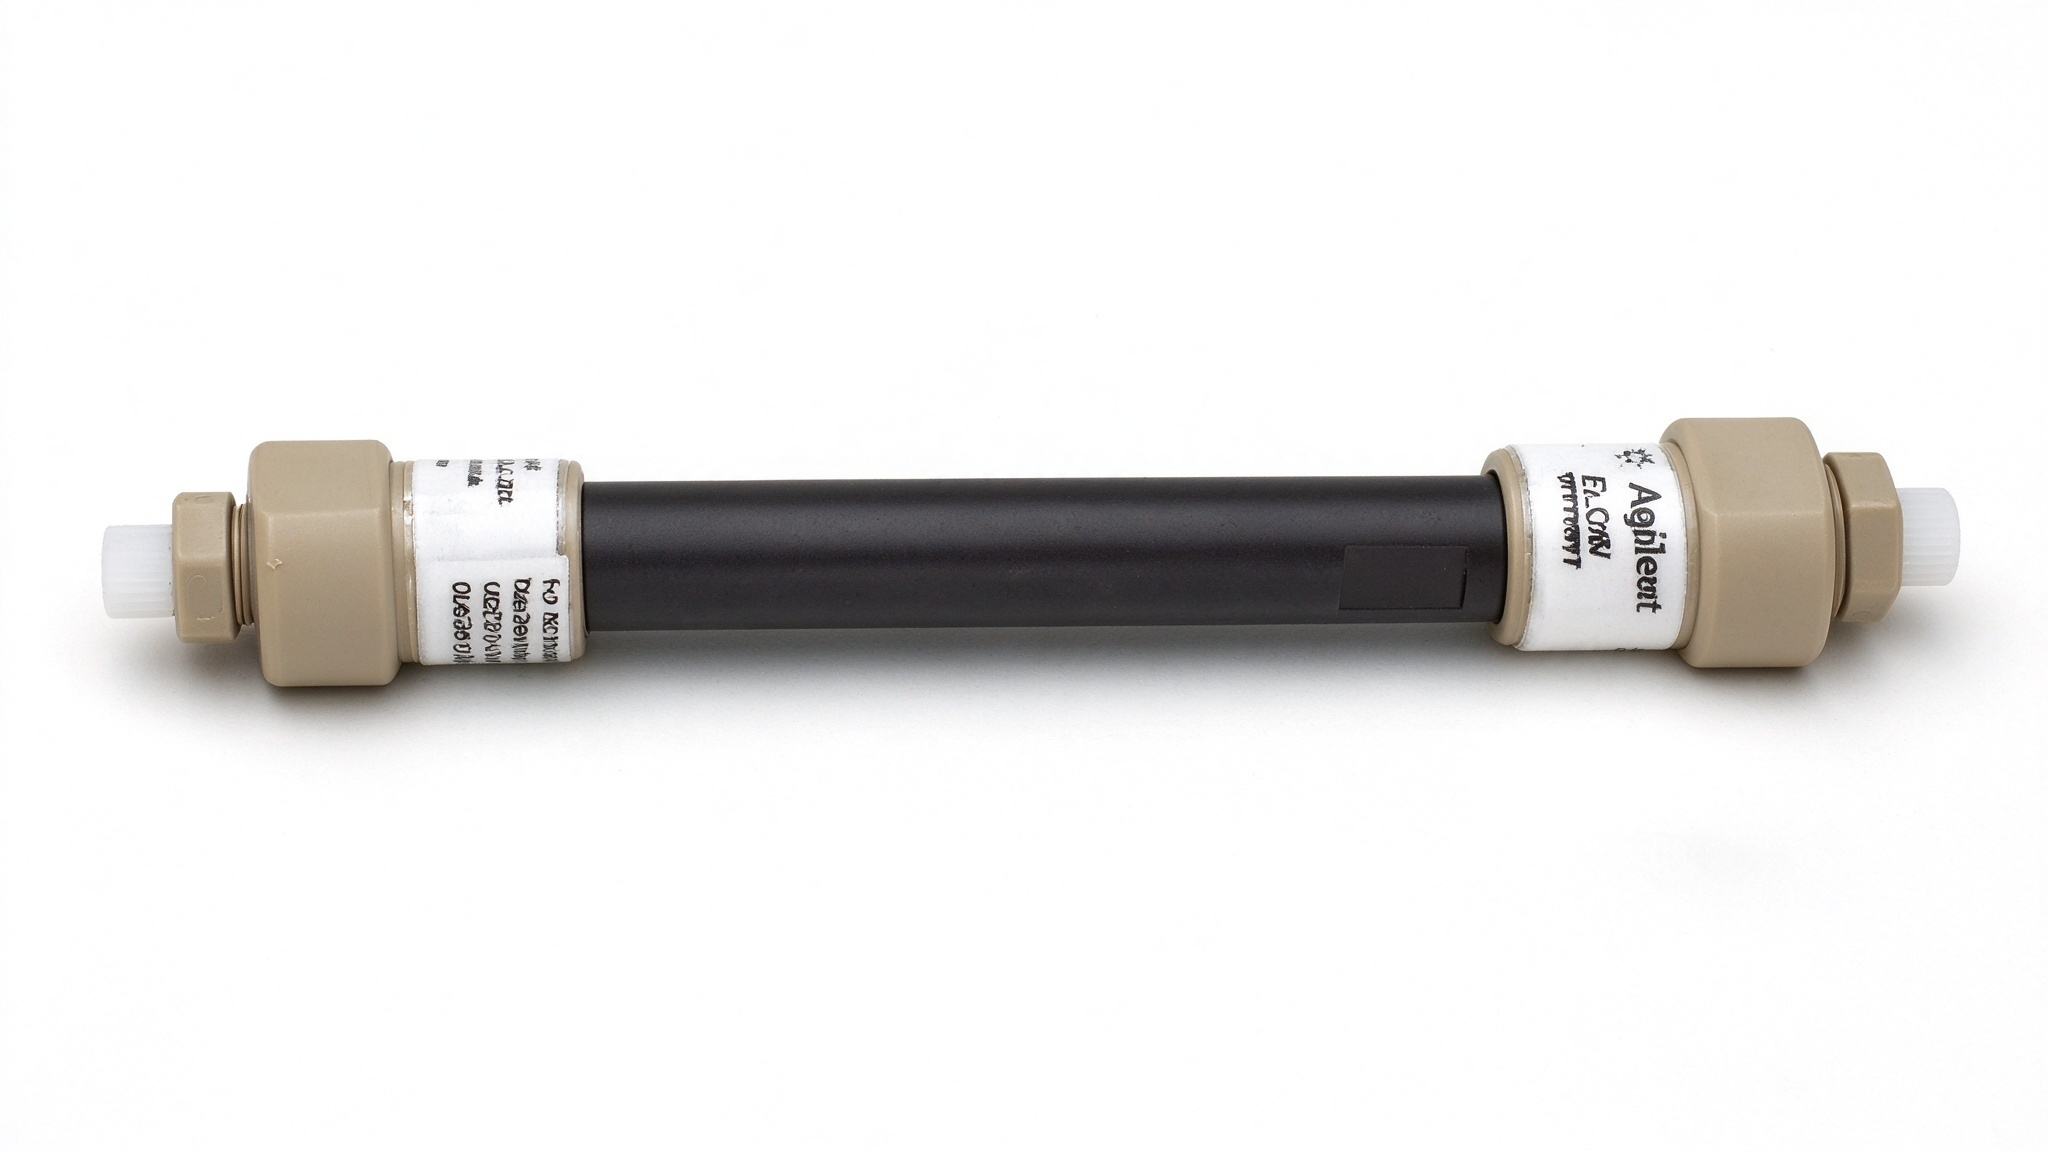
Agilent MARS Human-14
Thermo High Select 14 种高丰度蛋白去除柱
Bio-Rad ProteoMiner
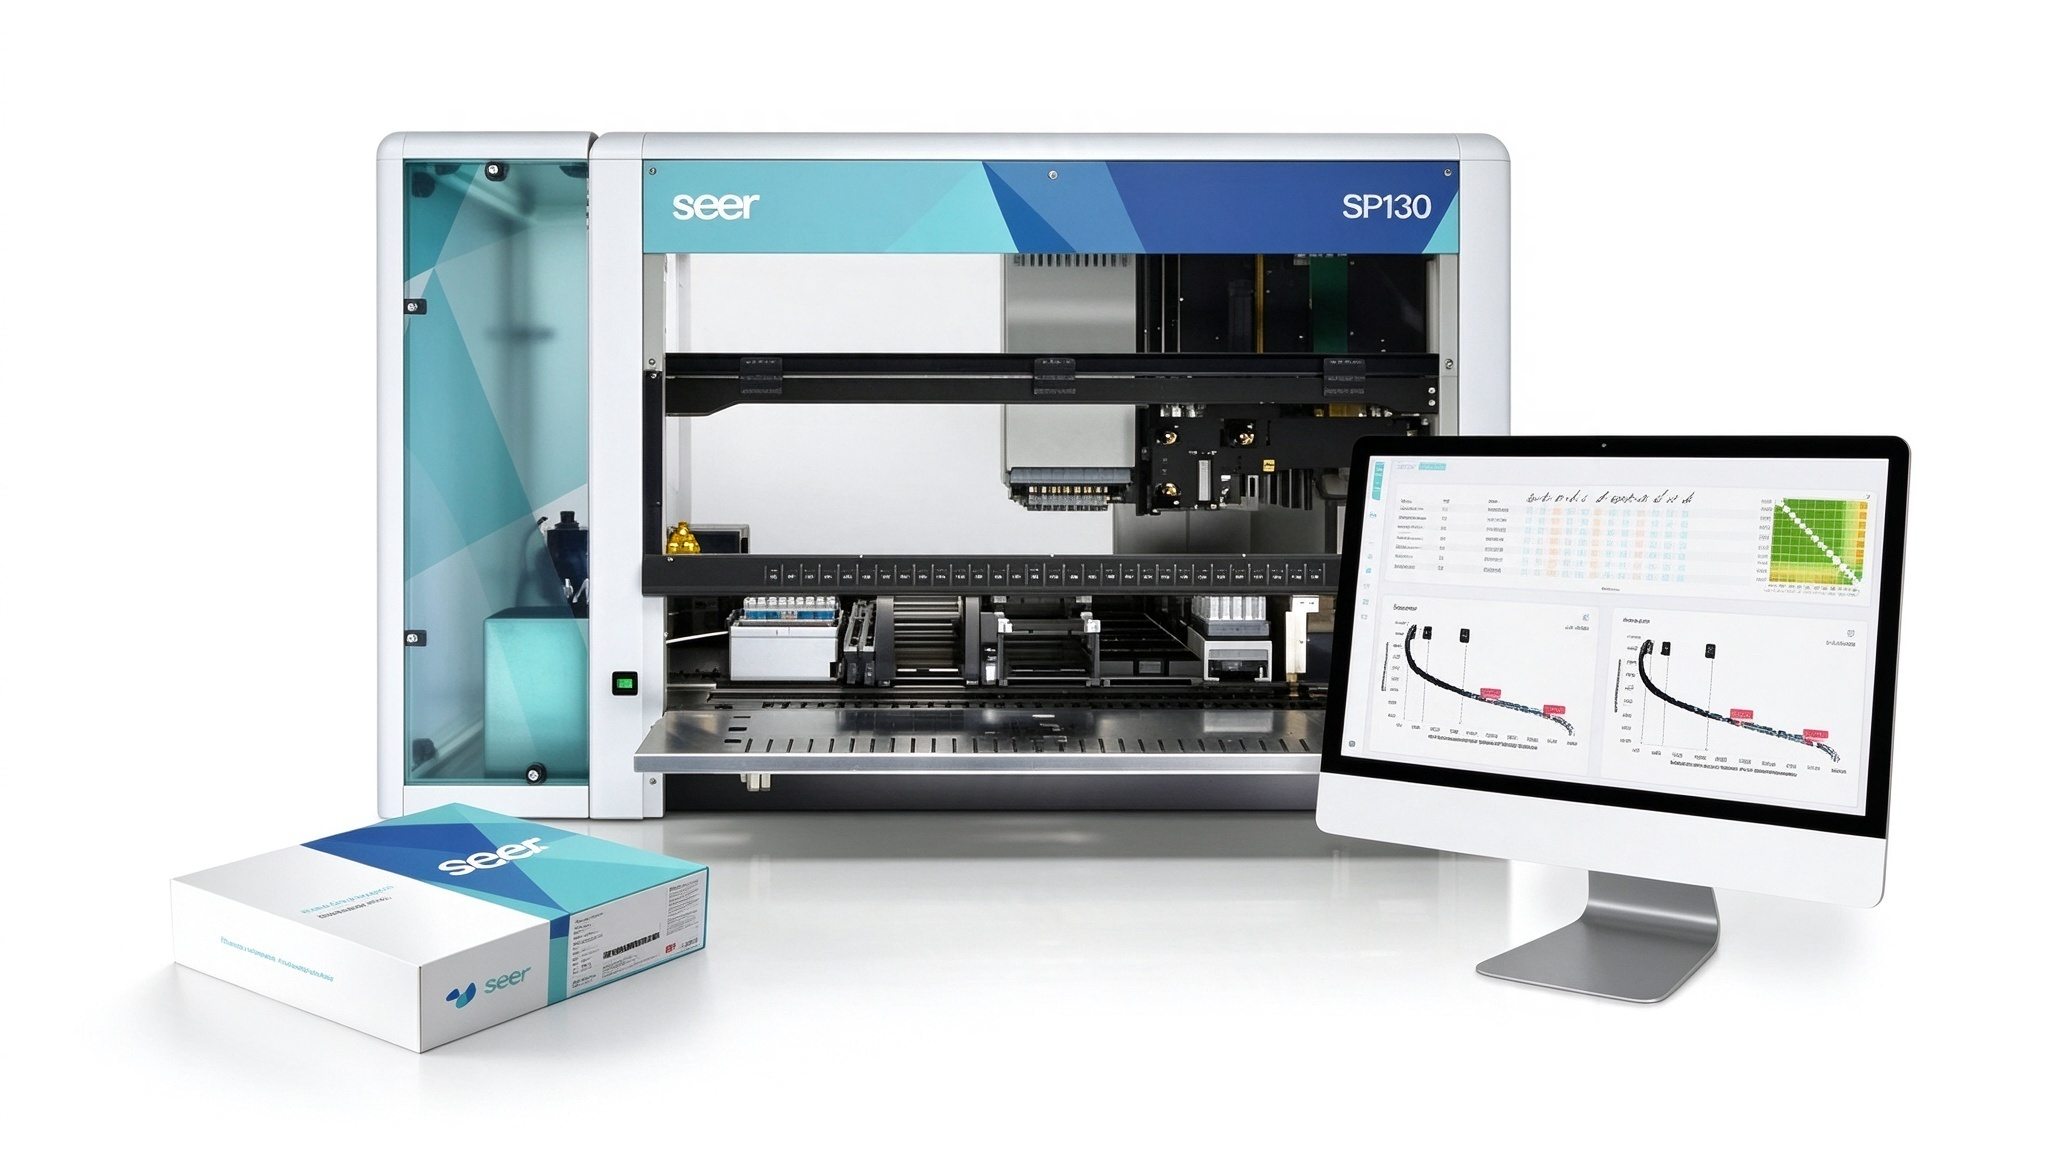
SEER Proteograph平台
落到研究设计上:按深度需求定前处理再定预算,目标蛋白在中等丰度时 14 种高丰度蛋白去除柱 够用且省钱,要挖低丰度或做大队列发现才上纳米富集;发现队列每组 30 例起步(每组 <15 例很难扛住统计功效),务必预留独立验证队列;批次设计是生死线,随机化上机、穿插混合 QC、优先 DIA(缺失值显著少于 DDA)。只有质谱能做的事别犹豫:翻译后修饰(磷酸化、糖基化)、蛋白形式(proteoform)、组织溯源、非模式物种。
常见坑:冻融次数不控制;不同批次不做校正就合并分析。
(二)Olink:大队列的标准化答案,先查蛋白在不在 panel 里
Olink 的核心是 PEA(邻位延伸分析):一对偶联寡核苷酸的抗体同时识别同一蛋白的两个表位,探针靠近后杂交延伸,经 PCR/NGS 读数。双表位要求显著降低了单抗非特异结合带来的交叉反应。产品线多种选择,对应完全不同的阶段:Target 96/48(约 1 μL,固定疾病 panel,适合验证)、Reveal(约 4 μL、约1034蛋白、NGS 读数,适合炎症免疫等中通量的研究)和 Explore HT(约 2 μL、约 5400 蛋白、NGS 读数,适合人群级发现)。
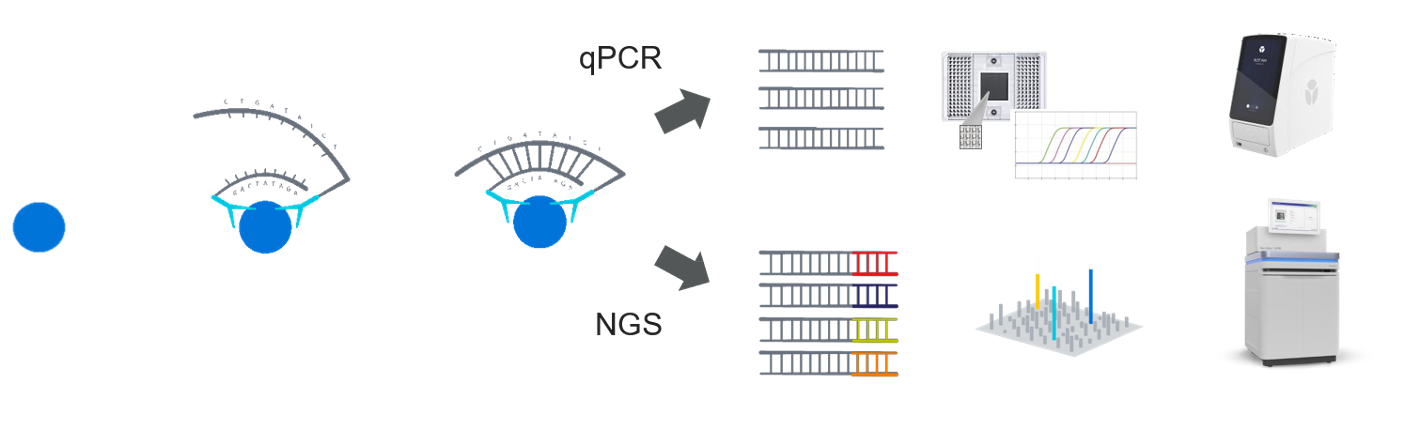
图3 Olink 原理示意图
落到研究设计上:第一步永远是查 panel,先把候选蛋白列表与官网 panel 构成逐一对一遍,目标蛋白不在里面后面一切免谈,这是 Olink 项目最常见的返工原因;1–4 μL 的上机量让它成为珍贵样本的优先选择,儿科队列、稀有临床样本、同一对象多时间点纵向采样几乎只能选它;做 pQTL 要有基因型数据加千人级以上规模才有效能,最好复用 UKB-PPP 做先验或外部验证。
两个数据层面的坑要提前排:NPX 是 log2 尺度的相对定量而非绝对浓度,跨批次合并必须设计桥接样本;Olink 与 SomaScan 的跨平台一致性只有中等水平,发现换验证平台或中途换平台都是设计事故。另外,低丰度 assay 落在 LOD 以下的比例要提前评估,分析前做检出率过滤。
(三)SomaScan:覆盖较广的筛查网,先算算样本够不够 55 μL
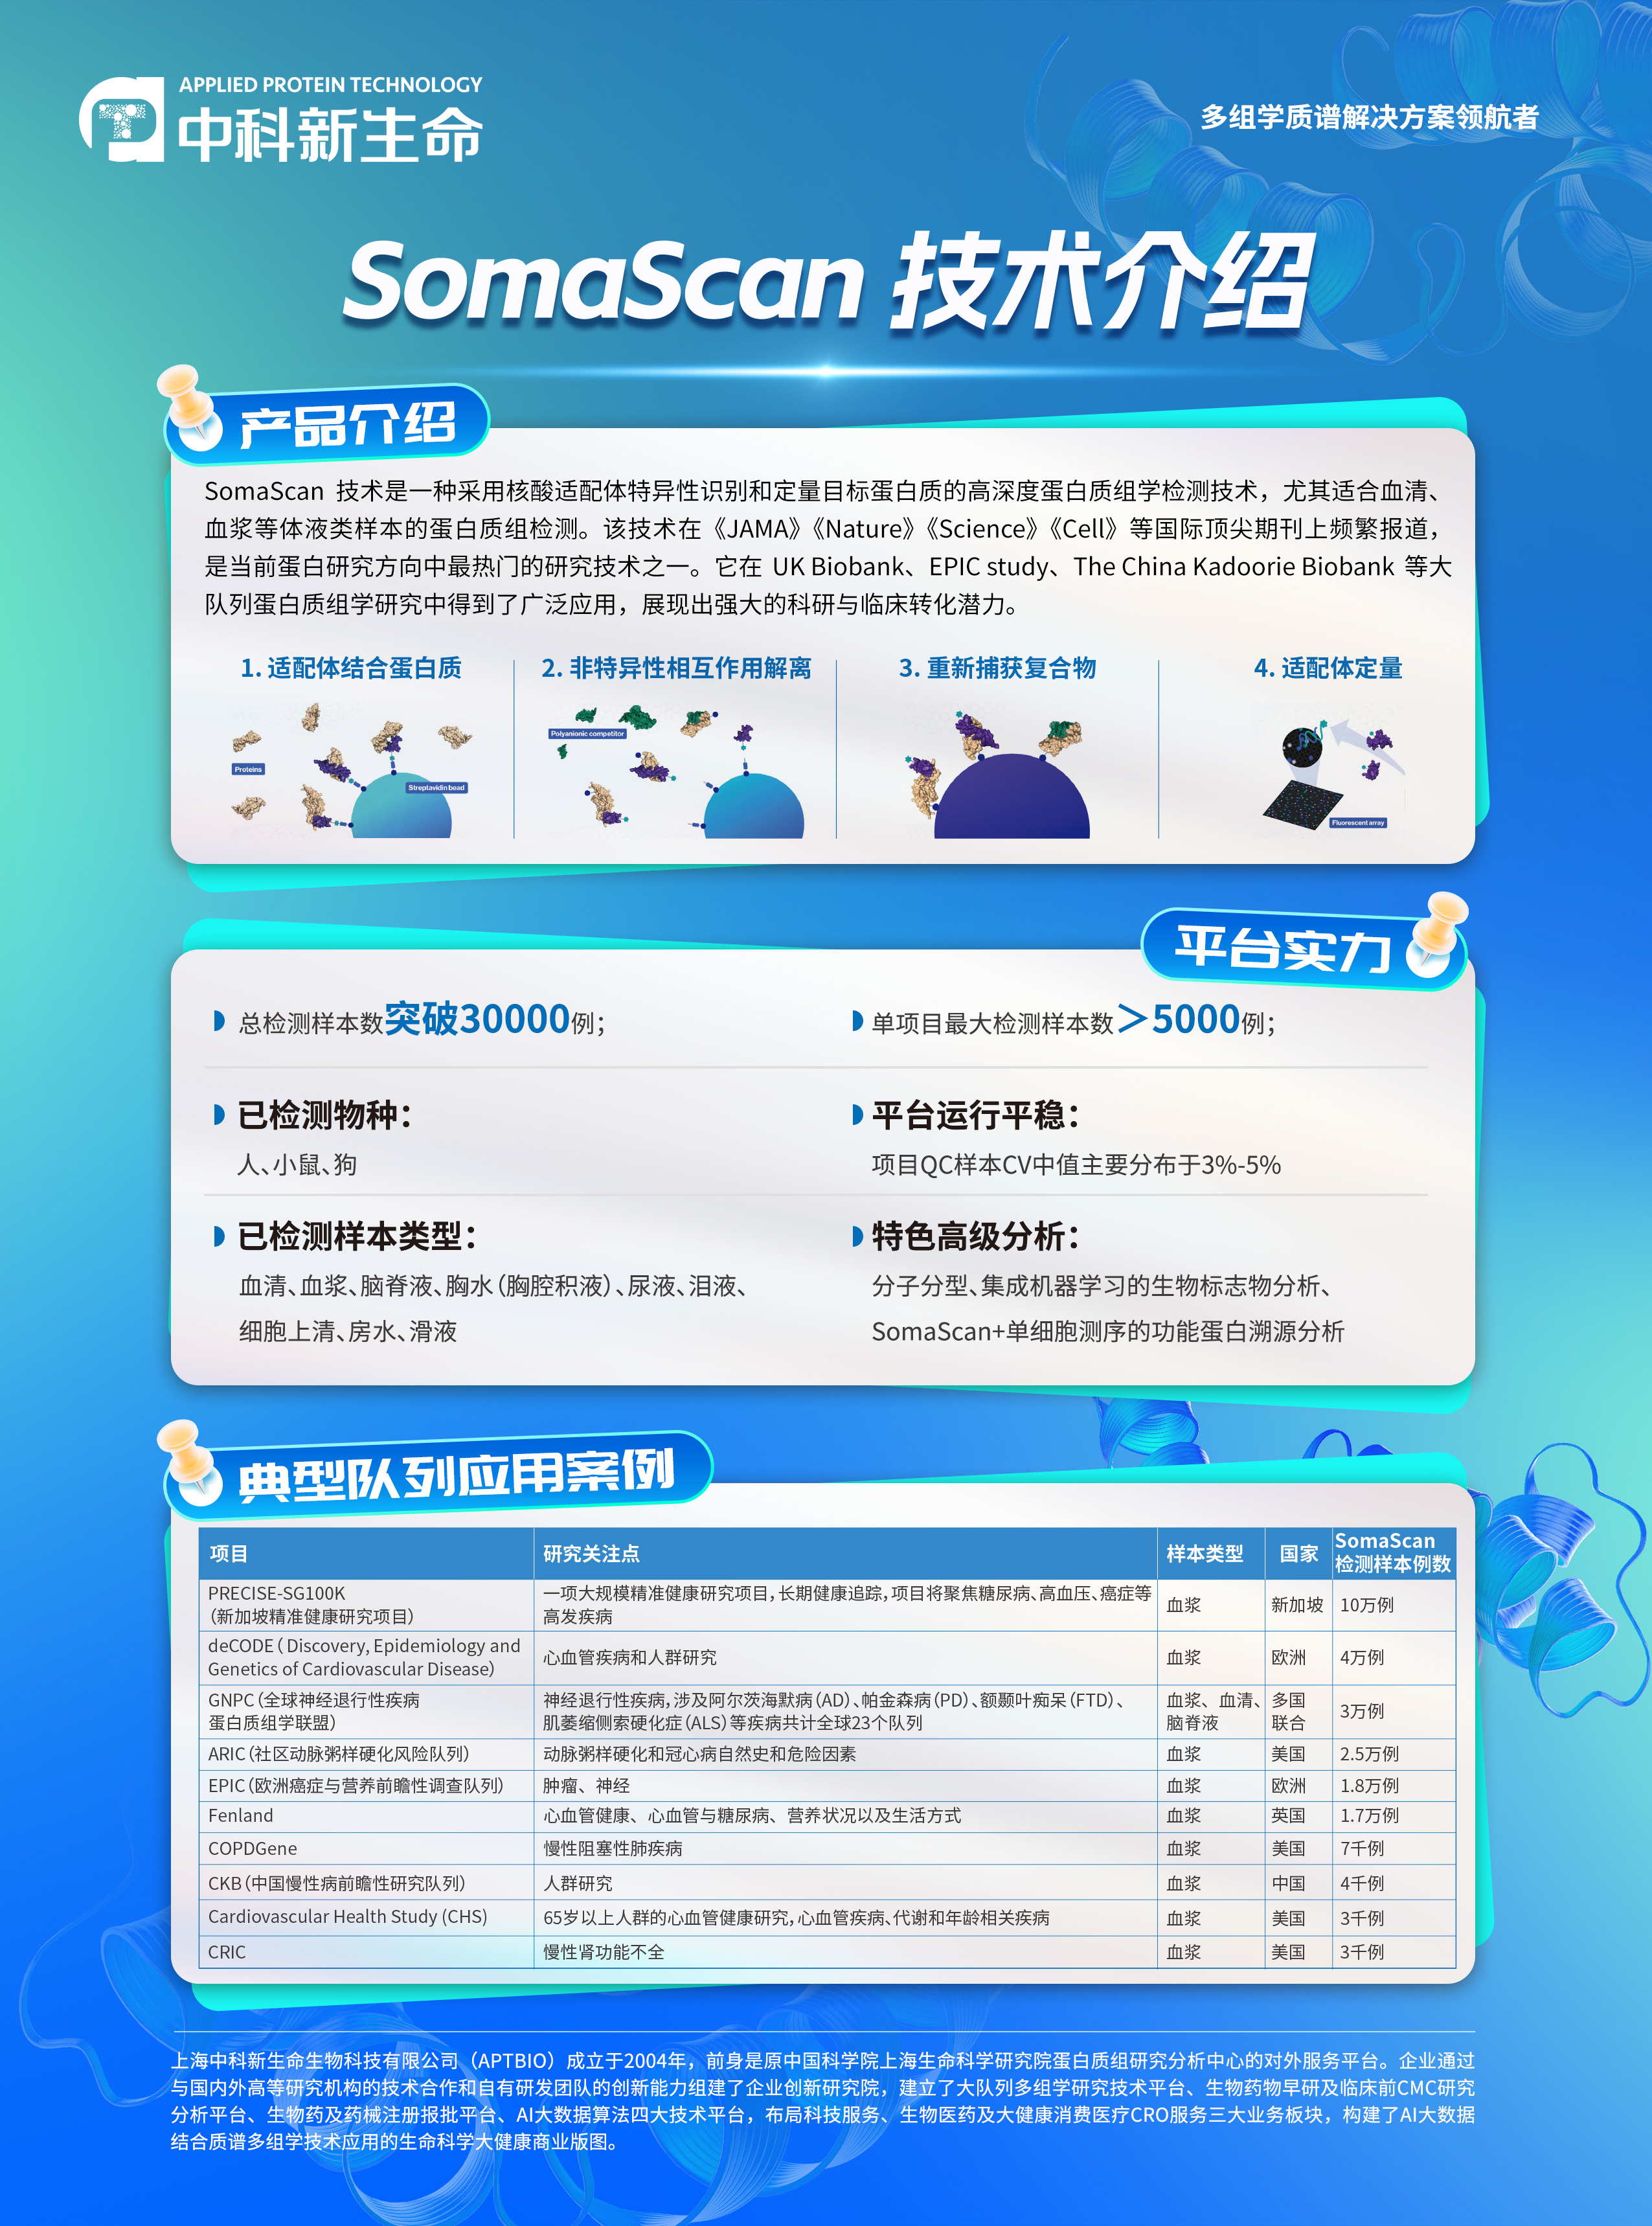
SomaScan 基于 SOMAmer 适配体,经化学修饰的核酸适配体与靶蛋白高亲和结合,通过微阵列杂交扫描读数。现行 11K 版本单次约 10,000 种蛋白,覆盖度居亲和平台之首,多篇研究论文和实测数据显示血清/血浆中位 CV <5%。典型应用是人群衰老(器官年龄时钟、健康寿命预测)和药物靶点发现。
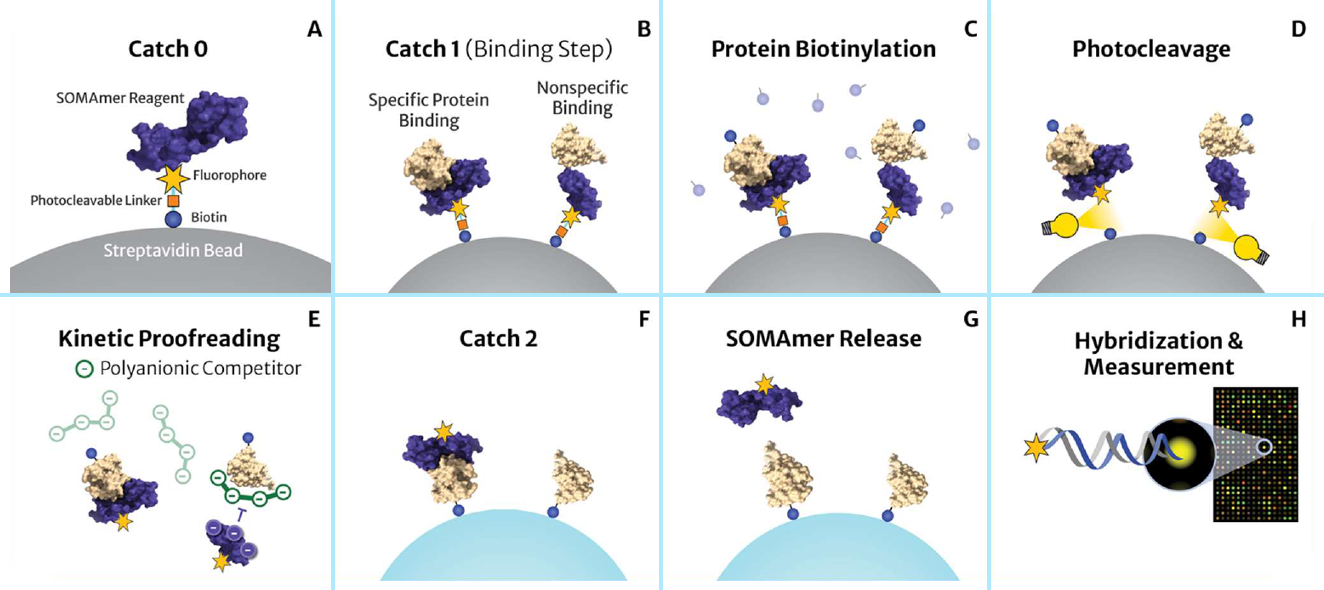
图4 SomaScan原理示意图
落到研究设计上:每例需要 55 μL 血浆/血清(送样通常要求 130 μL),面对平均只剩 20–30 μL 的珍贵冻存队列会直接出局;“不知道该看什么”时它是较优广筛,11K 覆盖意味着不必先假设方向,适合表型复杂、机制不清的队列做第一轮筛查;冰岛 deCODE、ARIC 等大队列的 SomaScan 数据公开可得,设计阶段就能拿来做工效估算、候选预筛和外部验证。
关键发现必须正交验证:适配体存在交叉反应和错靶的文献报道,凡要写进结论的核心蛋白,建议用抗体法(Olink/NULISA/ELISA)或质谱过一遍。同时要关注读出平台的迁移期,跨年、跨批次数据的口径一致性写进方案。
(四)NULISA:为“别人都测不到”的蛋白而生
NULISA(Alamar Biosciences)把免疫夹心和核酸扩增结合:一对单抗识别同一蛋白的两个表位,偶联寡核苷酸在靶蛋白介导下连接后扩增测序定量,专利降噪设计把灵敏度压到阿托摩尔(aM)级,动态范围宽到能在一次反应里同时覆盖高丰度与极低丰度蛋白。现有 CNS Disease Panel 120 、 Inflammation Panel 250Immune 340等多种panel,每个panel覆盖约100-300个蛋白,单样本约 10 μL,ARGO HT 自动化程度高。
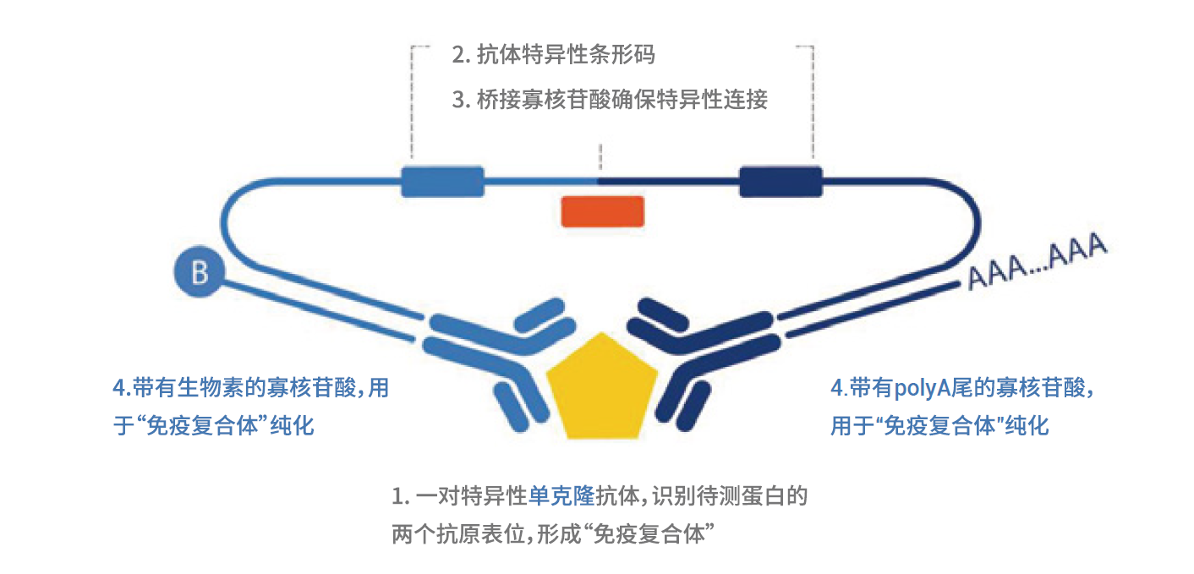
图5 NULISA 原理示意图
它是精测工具而不是广筛工具,上百个蛋白的覆盖决定了没法指望它做无偏发现。当目标蛋白落在 pg/mL–fg/mL 量级(基线水平的细胞因子、pTau217、GFAP、NfL 等神经标志物),其他平台 LOD 以下占比过高时它就是较优解,AD 血浆 pTau217 检测(文献报道 AUC 0.9 上下)是它的标签场景;10 μL 加自动化的组合,对几十到几百例的多中心验证很友好。
短板:panel 最窄;装机与送检渠道有限,周期需提前确认;平台上市时间短,公共参考数据积累远不如 Olink/SomaScan,审稿人若看重与已有大队列数据的可比性,这点要在文章里主动说明。
三、场景化选型:把你的项目对号入座
场景 1
大队列标志物发现(n ≥ 1,000,人群或遗传方向):优先选择 Olink Explore HT 或 SomaScan 11K。有基因型、要做 pQTL 偏 Olink,公共数据生态最成熟;追求最大覆盖、表型复杂无明确方向偏 SomaScan。涉及 panel 外蛋白或翻译后修饰时,追加质谱纳米富集做子队列。
场景 2
中小队列机制研究(n 30–300):假设不明确、想看全局,用质谱 DIA,深度按前处理定;假设明确且目标在 panel 内,用 Olink Target 96/48,成本和周期更可控。
场景 3
神经退行性疾病或超低丰度目标:优先选择 NULISA CNS 120 Panel(pTau217、GFAP、NfL、α-syn 一次打包);需要更广的炎症免疫可加 Inflammation 250 或Immune 340;要深挖磷酸化 tau 异构体这类机制,回到质谱。
场景 4
炎症因子谱(基线低水平细胞因子):NULISA Inflammation 250 或 Olink Inflammation panel;常规丰度区间的炎症标志物质谱和 SomaScan 也能覆盖,按样本量和预算取舍。
场景 5
候选已锁定、做临床验证(5–50 个):用 Olink Target / NULISA / ELISA 级别的靶向精测。不要为了“顺便多测点”上广覆盖平台,验证阶段最重要的是定量质量和批次可控。
场景 6
两阶段组合,预算有限的大项目较优解:发现阶段用质谱或 SomaScan 11K / Olink HT 打每组 30–80 例锁定候选;验证阶段换 Olink Target / NULISA 打大队列。预算向验证阶段倾斜,验证队列规模决定结论强度,发现阶段宁深勿广。
立项前过一遍四个问题:是要“发现”还是“验证”;样本有多少体积(<5 μL 只能 Olink,55 μL 以上才能谈 SomaScan);目标蛋白预期丰度在哪一档(fg/mL 级直奔 NULISA);有没有明确候选列表(有就逐平台核对 panel 覆盖率再下单,没有就走无偏或广覆盖路线)。
四、结语
血液蛋白质组学没有绝对的技术优劣排序,只有匹配度高低:质谱擅发现、亲和平台擅验证;抗体法特异性强、适配体法覆盖广;高丰度去除解决“能否看见”,NULISA 解决“能看多低”。近三年顶刊呈现的分工格局,就是一张现成的选型地图。要紧的,是把科学问题、样本条件、预算和数据目标放进同一个决策框架,再让技术去回答问题!
参考文献
[1] Cervia-Hasler C, et al., Persistent complement dysregulation with signs of thromboinflammation in active Long Covid. Science. 2024 Jan 19;383(6680):eadg7942.
[2] MoTrPAC Study Group; Lead Analysts; MoTrPAC Study Group. Temporal dynamics of the multi-omic response to endurance exercise training. Nature. 2024 May;629(8010):174-183.
[3] Deng Y, et al., Atlas of the plasma proteome in health and disease in 53,026 adults. Cell, 2024; 188, 253-271.e7.
[4] Álvez MB, et al., A human pan-disease blood atlas of the circulating proteome. Science. 2025 Dec 18;390(6779):eadx2678.
[5] Malmström E, et al., Human proteome distribution atlas for tissue-specific plasma proteome dynamics. Cell, 2025; 188, 2810-2822.e16.
[6] Ding Y, et al., Comprehensive human proteome profiles across a 50-year lifespan reveal aging trajectories and signatures. Cell. 2025 Oct 2;188(20):5763-5784.e26.
[7] Koprulu M, et al., Multi-cohort proteogenomic analyses reveal genetic effects across the proteome and diseasome. Cell, 2026; 189, 3339-3357.e11.
[8] Pandya T, et al., Plasma signals of lung tumor promotion for molecular cancer prevention. Cell, 2026; 189, 3903-3921.e26.
[9] Li J, et al., Multimodal clocks of human aging. Cell, 2026; 189, 4489-4511.e31.
[10] Topol EJ. The revolution in high-throughput proteomics and AI. Science. 2024 Sep 27;385(6716):eads5749.
*部分内容由 AI 辅助生成,若存在错漏、侵权等问题,请联系我方及时修正或删除。
中科优品推荐
【SomaScan免费测】中科新生命 2026 蛋白质组学研究资助计划重启!关注“中科新生命多组学服务”微信公众号,回复关键词“蛋白研究”报名,80 例 SomaScan Discovery (11K)样本免费测,做血液蛋白组、标志物发现、队列研究的同行别错过!!!
关于中科新生命
上海中科新生命生物科技有限公司(APTBIO)创立于 2004 年,由原中国科学院上海生命科学研究院蛋白质组研究中心孵化而来,是国内质谱多组学应用领域的开拓者。公司以 “AI + 质谱多组学” 双核驱动创新,构建智能化组学生态。拥有自主知识产权的质谱检测平台与 AI 大数据分析系统,聚焦科技服务、生物医药及大健康消费三大领域,为全球科研机构、医院、药企提供从基础研究到临床转化的一站式解决方案。融合多组学技术与人工智能,围绕生物标志物发掘、药物靶点筛选及个性化诊疗等方向,构建具有国际竞争力的组学数据库与算法模型,推动转化医学进程,加速创新药物研发,成为推动生命科学数字化升级的核心引领者。