- 移动端
上海中科新生命生物科技有限公司
18 年
手机商铺
- NaN
- 0
- 0
- 1
- 0
公司新闻/正文
队列专题 | 队列×蛋白组学重塑疾病风险预测与靶点发现——你的组学课题该发车了
0 人阅读发布时间:2026-10-13 20:26
APTBIO
队列专题
2023 年以来,Nature、Cell、Nature Medicine 等期刊连续发表了多项万人级血浆蛋白组学队列研究。这些工作共同指向四类可系统回答的科学问题:疾病的发病风险能否被提前预测、哪些蛋白可作为干预靶点、暴露与疾病之间是否存在因果关联、干预实施后分子表型如何动态变化。这一波集中产出的背后,是技术、资源与方法三类条件在同一时期同时成熟,而非单一热点的偶然叠加。下文先拆解三个拐点的具体约束,再给出四类问题的设计要素与课题定位路径,最后说明两类目前尚不能外推的结论。
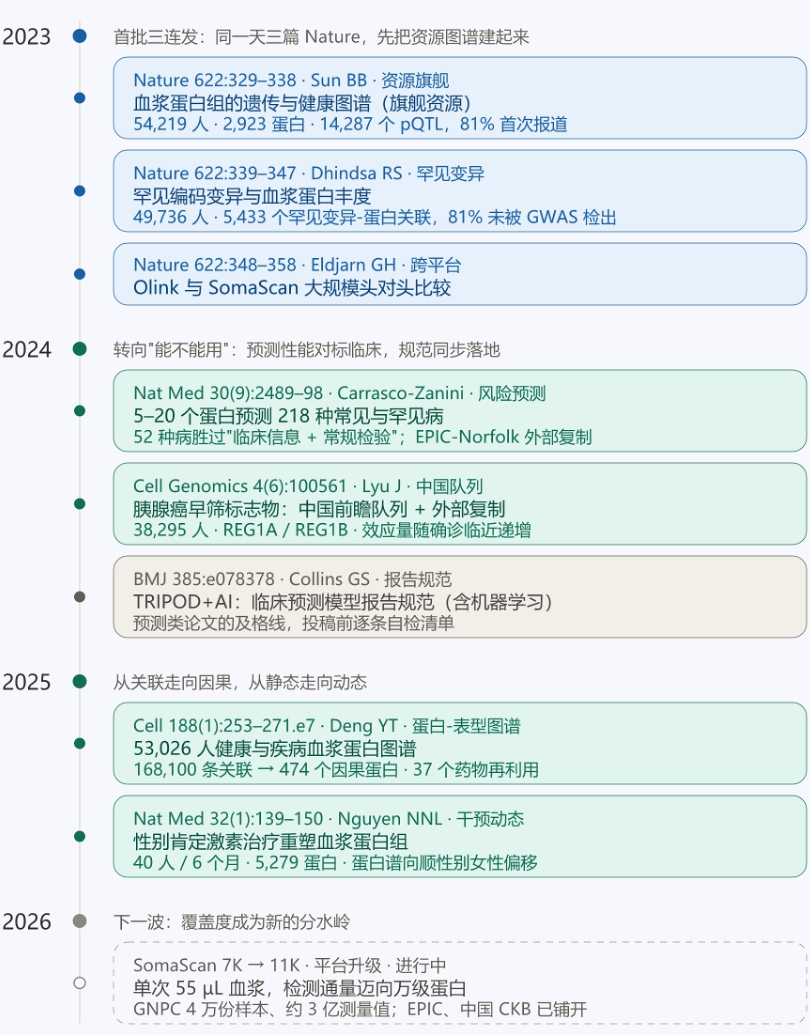
图1 顶刊大队列蛋白组学发文脉络时间轴
一、三个拐点:技术、资源与方法
1.1 技术拐点——检测平台从“不可行”到“可负担”
Olink、SomaScan 与质谱 DIA 三类平台将万人级蛋白定量由技术瓶颈转为常规选项。蛋白检测覆盖度从早期数百个提升至约 1 万个;在规模扩张的同时,单样本成本显著下降,使得在数万人中系统测量蛋白组成为可能。但三者的方法学原理与数据属性差异显著,选题时必须先明确:
Olink(PEA,proximity extension assay):
一对寡核苷酸标记的抗体与靶蛋白结合后发生 proximity extension,经 qPCR 或 NGS 定量。灵敏度可达 fg/mL 级,动态范围宽,特异性强;覆盖度受抗体库限制,当前最高约 5,000 个蛋白。输出为相对定量。
SomaScan(SOMAmer 适配体):
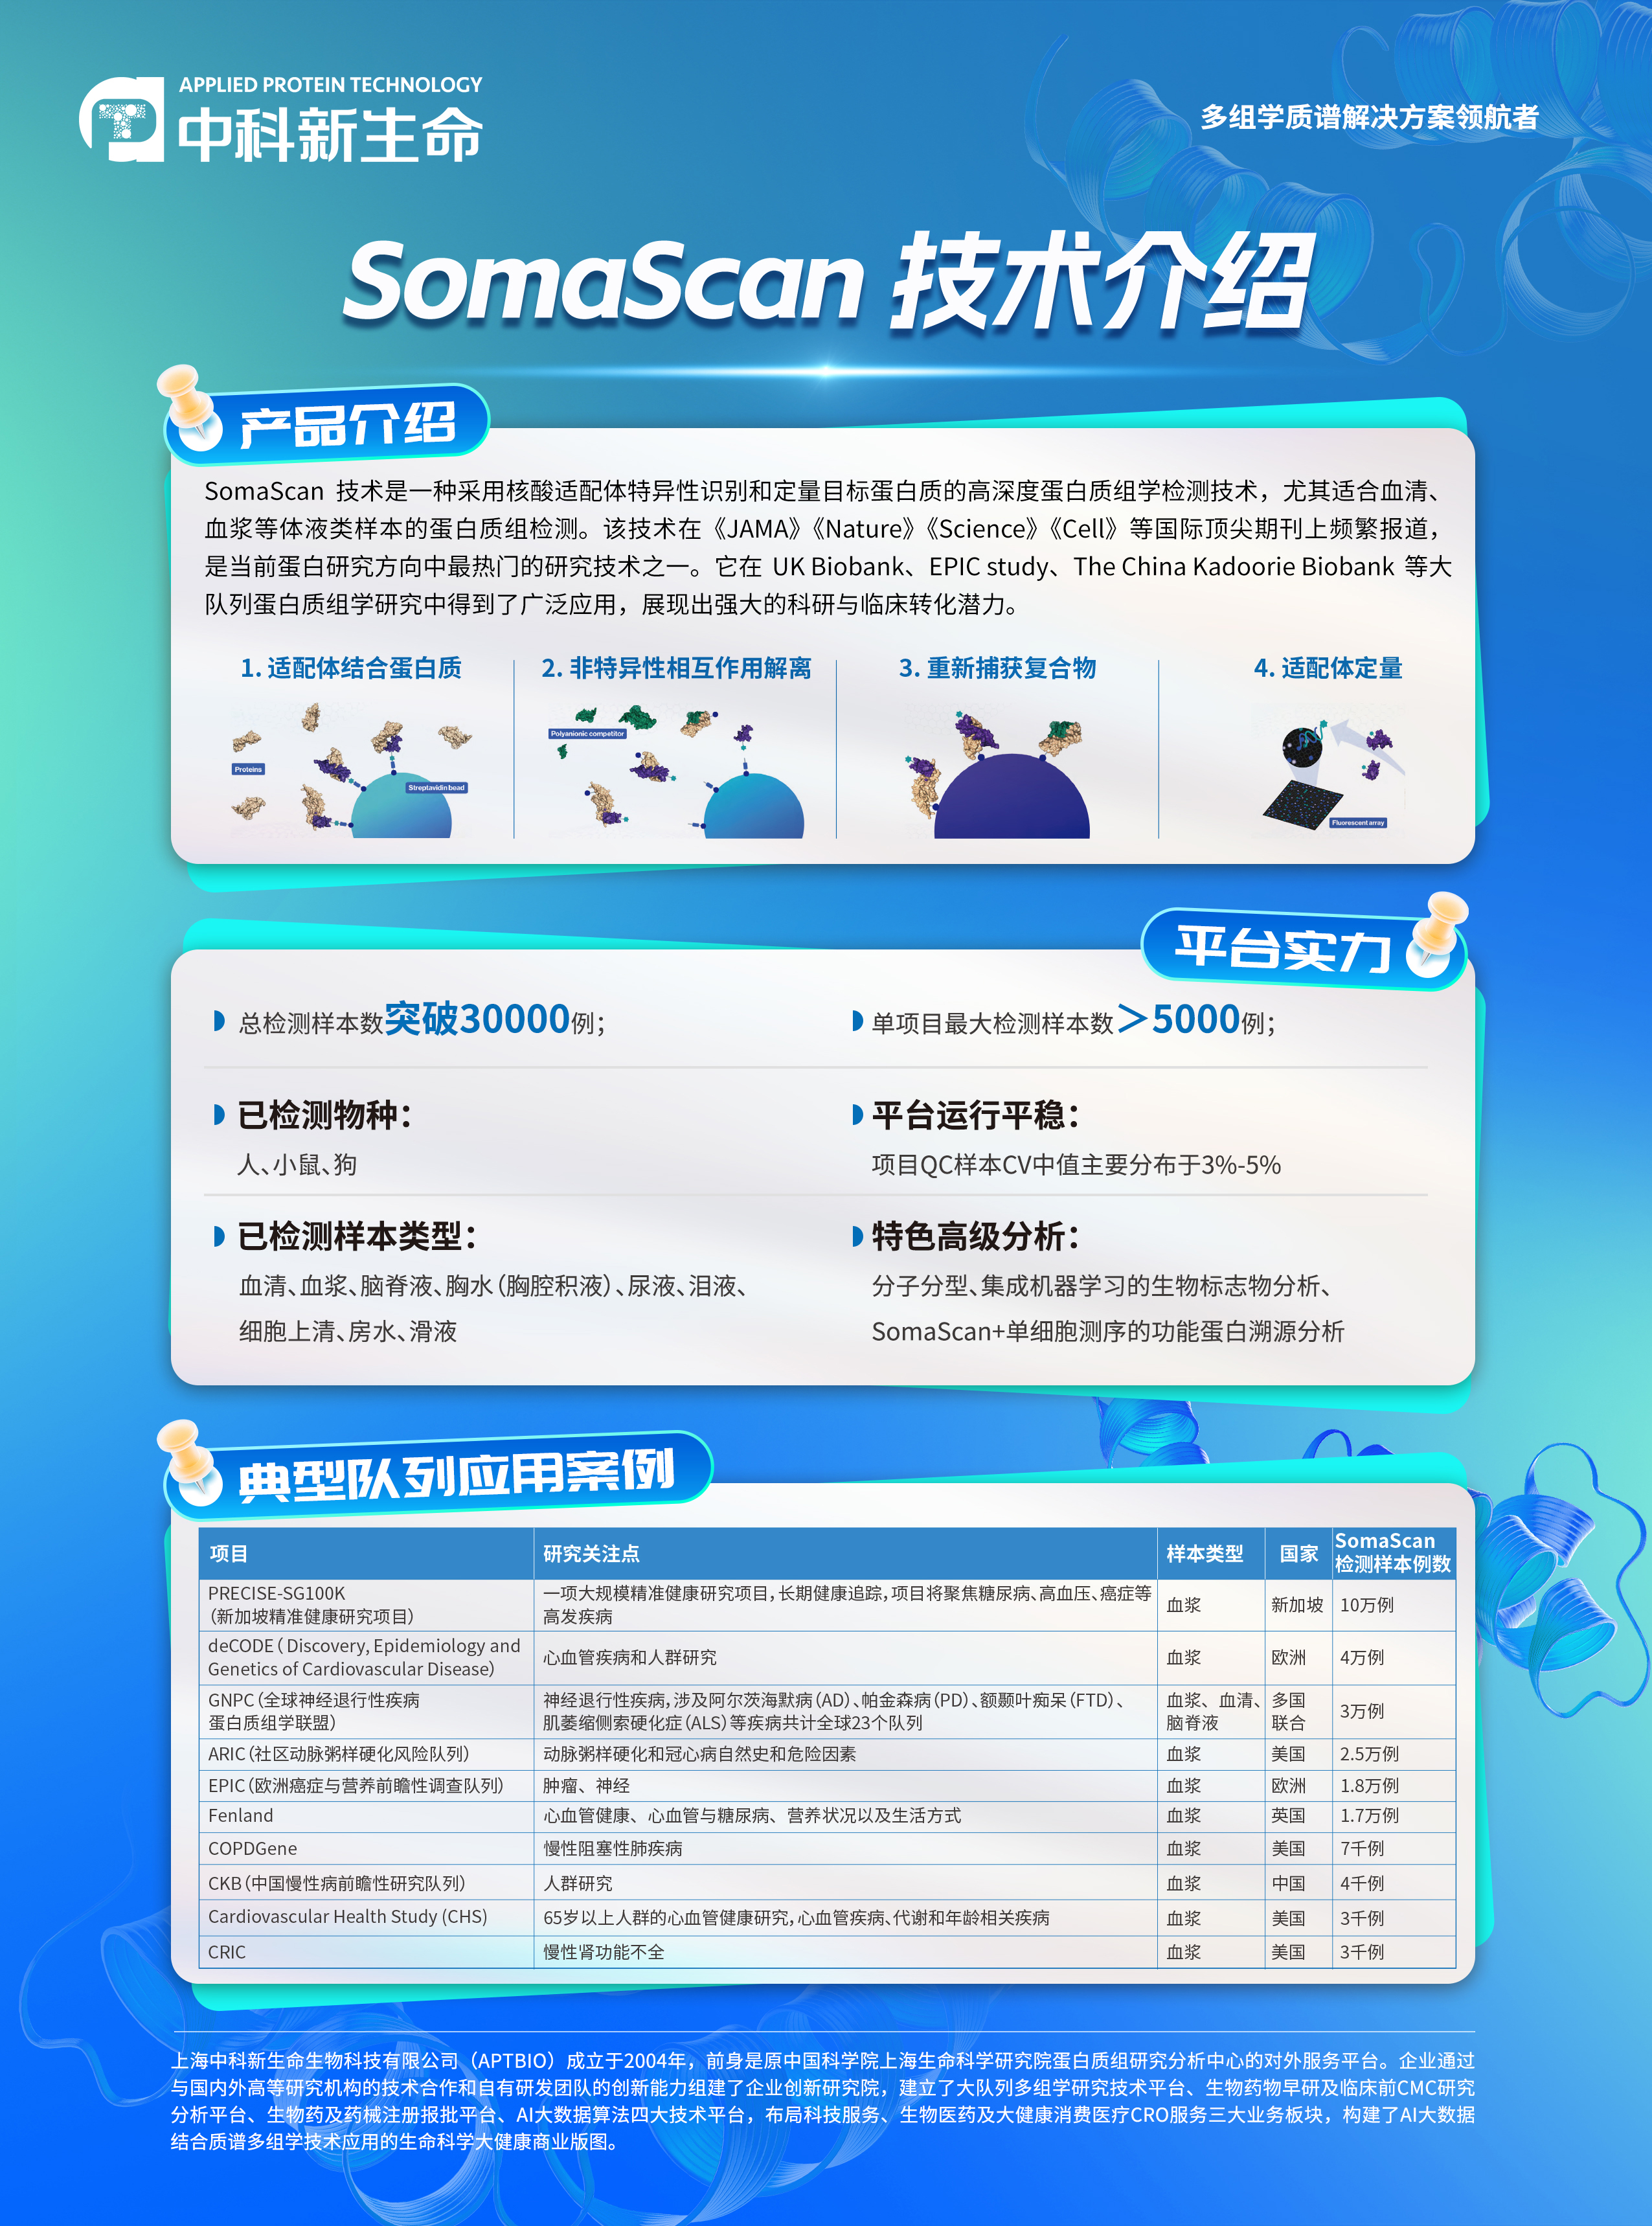
核酸适配体以分子识别结合靶蛋白,解离常数可达 nM–pM 量级,与单抗亲和力相当;单次可测约 10,000–11,000 个蛋白。输出为相对定量。
质谱 DIA(data-independent acquisition):
不依赖抗体,直接检测酶解肽段,理论上覆盖最广、最无偏;但不同仪器与实验室间差异较大,低丰度蛋白缺失值(missingness)偏高。可通过内标实现绝对定量,常规产出仍以相对定量为主。
Eldjarn 等(2023, Nature)通过遗传共定位分析发现,同一蛋白在 Olink 与 SomaScan 两平台上的绝对信号不可比,仅有变化方向可对比。这是平台选择时必须计入的数据可比性约束。
1.2 资源拐点——大队列与纵向样本
UKB-PPP(UK Biobank Pharma Proteomics Project)已完成约 5.4 万人、近 3,000 个蛋白的检测(以 Olink 为主),并配套基因型与表型。CKB(China Kadoorie Biobank)是中国人群专属大型队列,已完成约 2,000 人、近 7,000 个蛋白的双平台(Olink + SomaScan)检测。缺乏同等规模的人群资源与纵向样本,蛋白组研究难以摆脱小样本不稳定与无法外部验证的困境。
1.3 方法拐点——pQTL 联合 MR 的因果定位
蛋白与疾病的统计学关联并不等价于因果。整合蛋白质数量性状位点(pQTL)与孟德尔随机化(MR),可将“关联性证据”与“因果性证据”分离。以顺式 pQTL(cis-pQTL)作为工具变量进行 MR,可在很大程度上规避反式 pQTL 带来的水平多效性(horizontal pleiotropy);进一步通过共定位分析(colocalization)排除连锁不平衡导致的假关联,并用 Steiger 检验确认方向性,构成从关联到因果的证据链。
二、 大队列蛋白组学可回答的四类科学问题
2.1 风险预测(risk prediction)
Carrasco-Zanini 等(2024, Nature Medicine)基于 UKB-PPP,整合 41,931 名受试者的近 3,000 个血浆蛋白与临床变量,为 218 种常见与罕见病建立了 10 年发病风险的稀疏预测模型。所谓“稀疏”,指通过正则化回归(如 LASSO)仅遴选 5–20 个蛋白即可建模,而非堆叠数百个特征。该模型在 67 种疾病上判别力优于纯临床模型,其中 52 种优于“临床 + 37 项常规化验”模型;在 EPIC-Norfolk 外部队列中复现了其中 6 种疾病的预测增益,提示其泛化能力。方法学上,风险预测模型应同时报告区分度(C-index / AUC)与校准度(calibration slope 与 intercept),并以事件数而非总样本量换算的事件每变量比(EPV, events per variable)评估样本充足性;外部验证宜覆盖时序、地域或平台差异。这类研究须遵循 TRIPOD+AI 报告规范(Collins 等, 2024, BMJ)。
2.2 靶点发现(target discovery)
Deng 等(2025, Cell)报道了 53,026 名成人的血浆蛋白图谱,识别出 2,920 种蛋白与 406 种现患及 660 种新发疾病类别相关;整合 pQTL 后进一步锁定 474 个具因果证据的蛋白,并据此提出 37 项老药新用(drug repositioning)机会与 26 个安全性良好的候选靶点。其价值不在于蛋白清单本身,而在于“关联 → pQTL → MR → 共定位 → 成药性评估”的因果证据链是否完整,以及是否兼顾组织表达谱与脱靶安全性。
2.3 因果定位(causal localization)
Lyu 等(2024, Cell Genomics)基于中国东风-同济(DFTJ)前瞻性队列,发现 REG1A/REG1B 与胰腺癌相关,并在 UKB-PPP 中成功复制;孟德尔随机化进一步支持其因果关联。该工作示范了“相关 → 因果”的推进路径,也表明中国人群队列能够产出可被独立队列复制的发现。
2.4 动态监测(dynamic monitoring)
Nguyen 等(2025, Nature Medicine)借助性别肯定激素治疗的随机对照试验,并引入 UKB 作为外部参照,展示纵向蛋白组如何捕捉干预响应。只有多时点采样才能刻画个体内“变化轨迹”,而非停留在横断面“快照”。
三、设计要素与平台选择的约束
表 1 汇总四类科学问题对应的核心设计要素;表 2 给出平台选择的决策依据。
表1 四类科学问题的设计要素对照
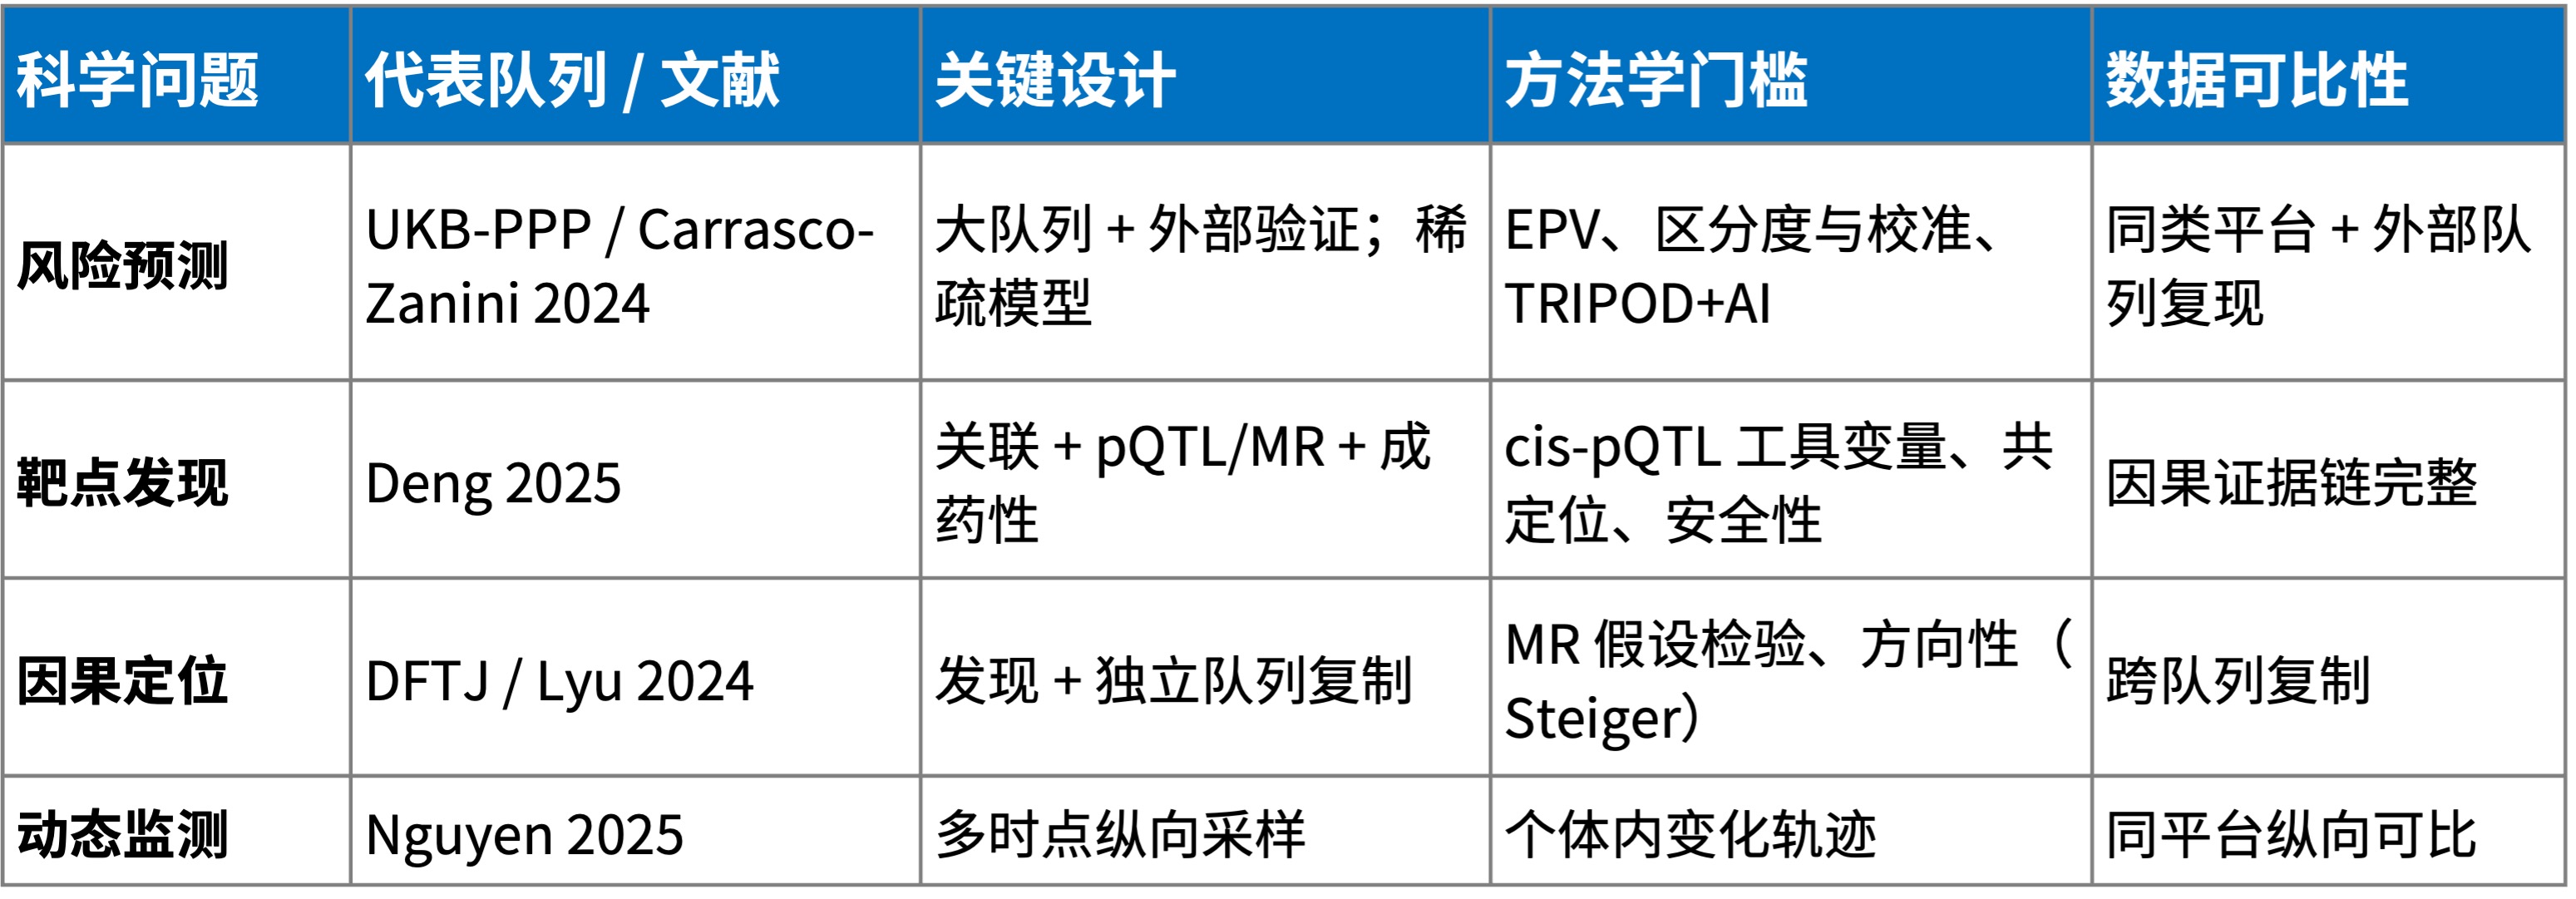
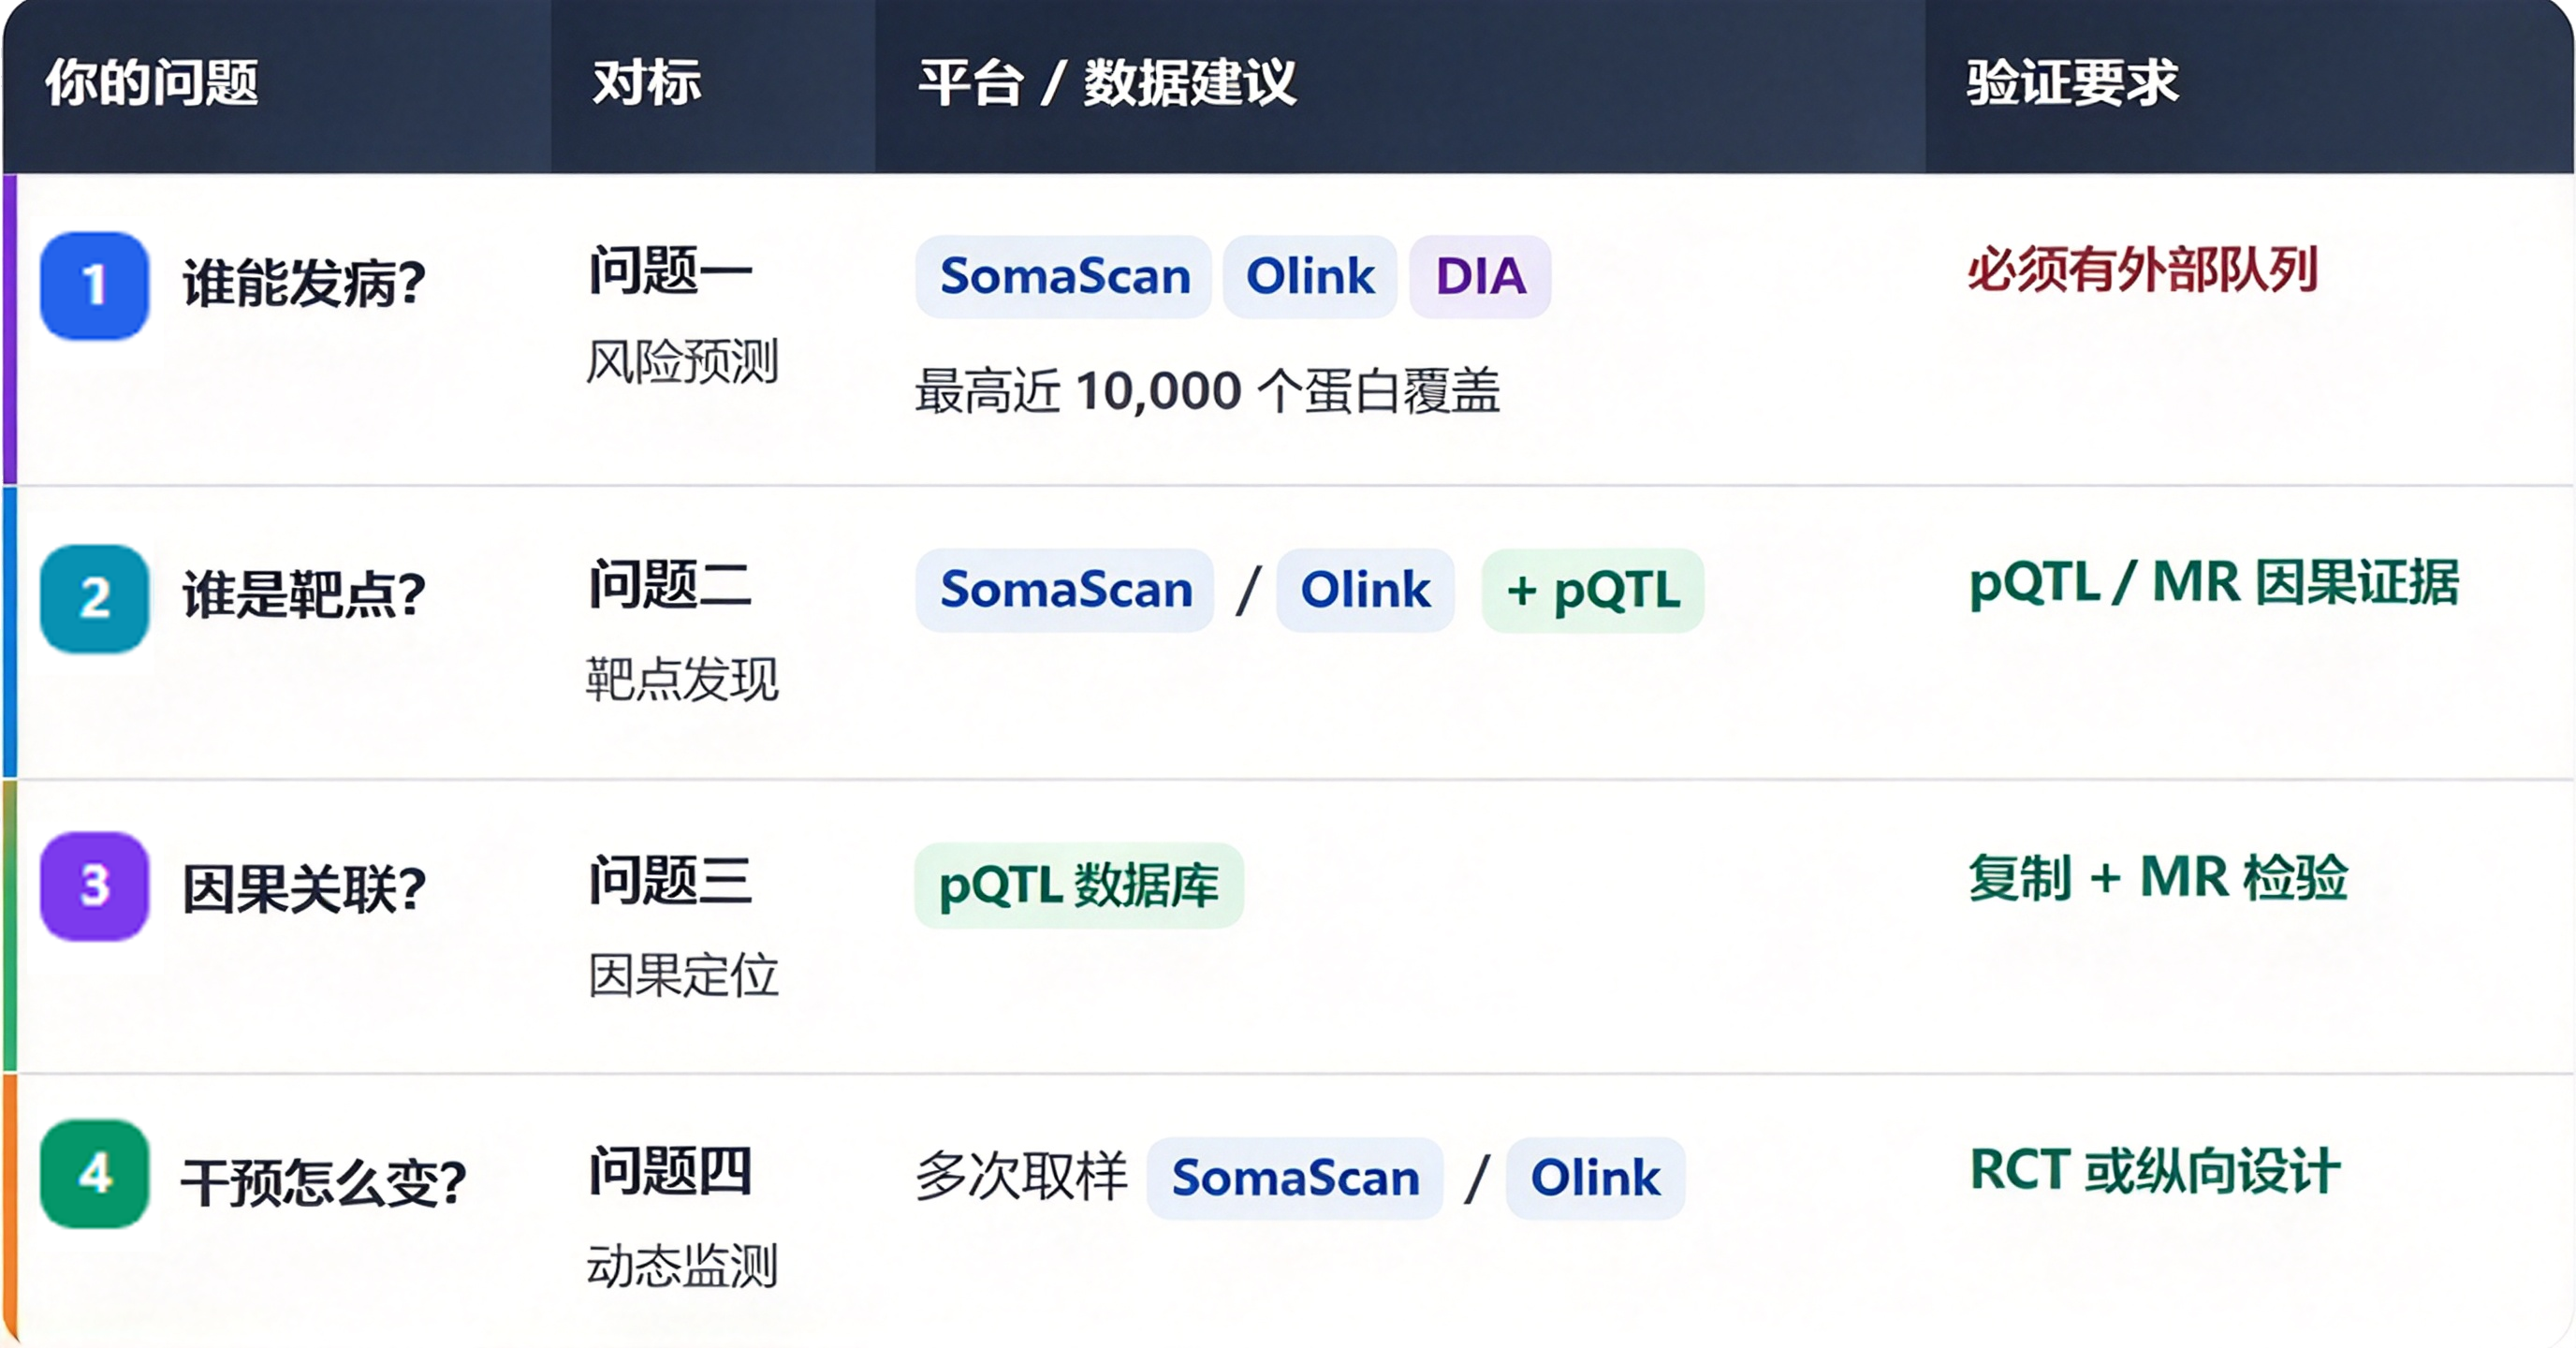
图2 四类科学问题的对标判断矩阵
表2 平台选择决策依据
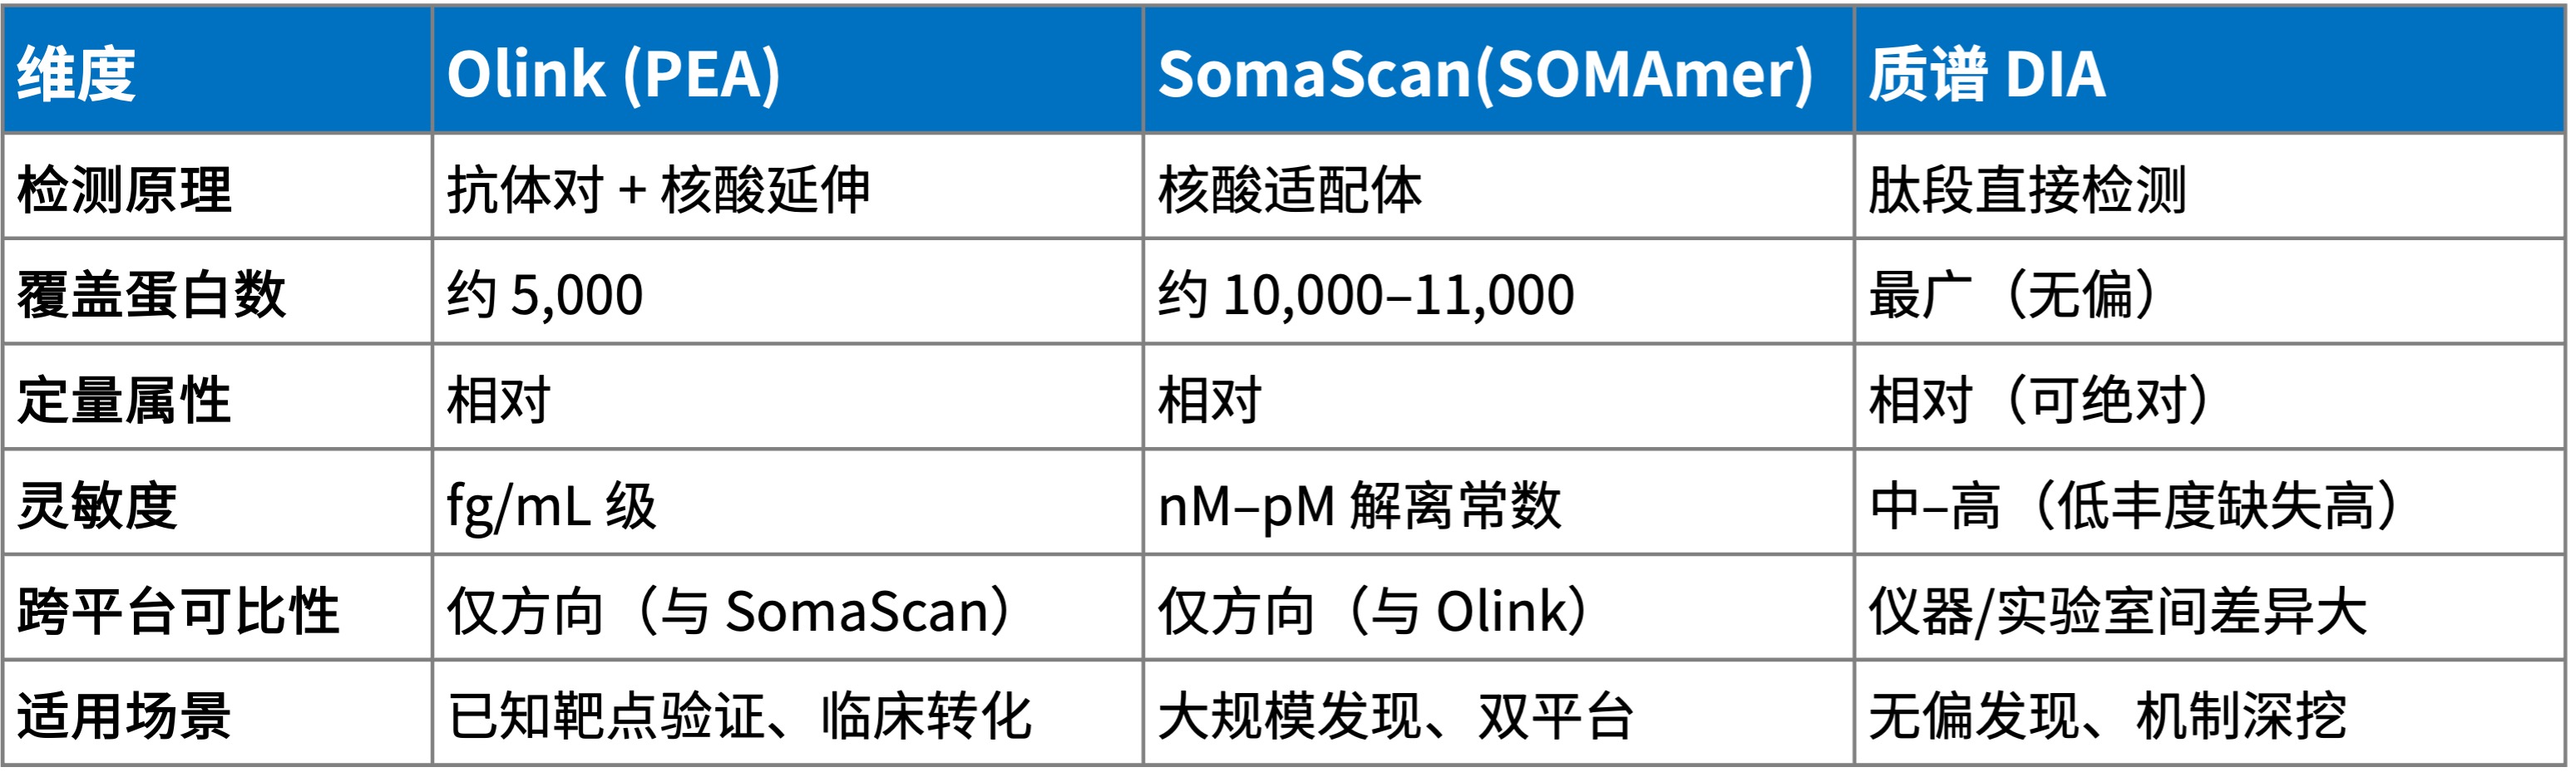
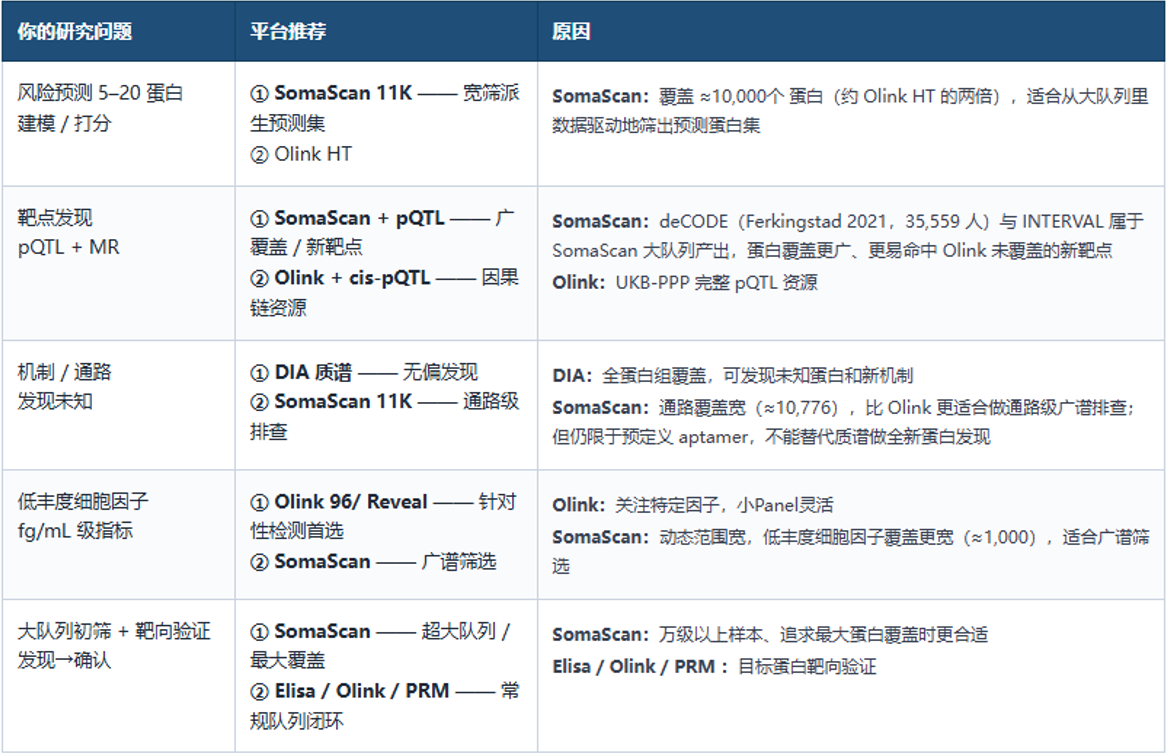
图3 平台选择决策矩阵
四、课题定位路径:从科学问题到方法闭环
课题能否对标顶刊,取决于能否先界定科学问题类型,再据此补全方法闭环。建议按以下顺序自检:
1. 科学问题类型:
属于预测、靶点、因果定位还是动态监测?预测类必须配套大队列与外部验证;机制或靶点类必须可获取pQTL(尤其 cis-pQTL)资源;动态类必须有多时点设计。
2. 样本量与 EPV:
风险预测以事件数换算 EPV(经验阈值 ≥10 事件/变量)作为充足性依据,而非仅看总样本量。
3. pQTL 资源可及性
是否已规划与 UKB-PPP / deCODE / CKB 等资源方合作?cis-pQTL 本质是遗传工具变量,需提前解决数据库可及性与合规。
4. 外部验证队列:
预测与因果结论若无独立队列复现,难以被方法学审稿认可。
5. 因果证据链完整性:
相关 → pQTL → MR → 共定位 → 功能实验,任一环节缺失均需补齐;横断面关联在无 MR 支持时应如实表述为“关联”而非“因果”。
五、国自然申请书的方法学落点
若将上述课题写入国自然申请书,应优先明确对标的问题类型,而非仅写“利用蛋白质组筛选标志物”。具体而言:风险预测须阐明 EPV 估算与外部验证方案;靶点发现须论证 pQTL/MR 与共定位的可行性及成药性评估;动态监测须说明多时点采样与样本留存。评审关注方法学闭环——即从科学问题、队列资源、检测平台到因果证据链是否自洽,而非热点词汇的堆砌。
六、结论外推的两类方法学边界
第一类边界是关联与因果的混淆。横断面或仅具相关性的蛋白,投稿时若使用“导致”等因果措辞,通常会被方法学审稿人直接质疑。当前因果结论默认需 pQTL 与 MR 支持;缺乏此类证据时应表述为“相关”或“关联”,避免以“提示”等弱措辞暗示因果。
第二类边界是跨平台数值的直接比较。Olink 与 SomaScan 基于不同检测体系,同一蛋白在两平台间的绝对信号不具可比性,仅可比较变化方向(Eldjarn 2023)。
综上,大队列蛋白组学的选题前提是先界定所要回答的四类问题中是哪一类,再据此选择数据来源与方法规范;问题未界定,方法便容易失焦,研究既难以达到顶刊的方法学标准,也缺乏转化价值。
参考文献
[1] Carrasco-Zanini J, Pietzner M, Davitte J, et al. Proteomic signatures improve risk prediction for common and rare diseases. Nat Med. 2024;30(9):2489-2498. PMID:39039249. DOI:10.1038/s41591-024-03142-z
[2] Deng YT, You J, He Y, et al. Atlas of the plasma proteome in health and disease in 53,026 adults. Cell. 2025;188(1):253-271.e7. PMID:39579765. DOI:10.1016/j.cell.2024.10.045
[3] Lyu J, et al. Identification of biomarkers and potential therapeutic targets for pancreatic cancer by proteomic analysis in two prospective cohorts. Cell Genomics. 2024;4(6):100561. PMID:38754433. DOI:10.1016/j.xgen.2024.100561
[4] Nguyen NNL, et al. Plasma proteome adaptations during feminizing gender-affirming hormone therapy. Nat Med. 2025. DOI:10.1038/s41591-025-04023-9
[5] Eldjarn GH, et al. Large-scale plasma proteomics comparisons through genetics and disease associations. Nature. 2023;622. PMID:37794188. DOI:10.1038/s41586-023-06563-x
[6] Sun BB, et al. Plasma proteomic associations with genetics and health in the UK Biobank. Nature. 2023;622(7982):329-338. DOI:10.1038/s41586-023-06592-6
[7] Collins GS, et al. TRIPOD+AI: Transparent Reporting of a multivariable prediction model for Individual Prognosis or Diagnosis with an Artificial Intelligence Model. BMJ. 2024;385:e078378. PMID:38626948. DOI:10.1136/bmj-2023-078378
*部分内容由 AI 辅助生成,若存在错漏、侵权等问题,请联系我方及时修正或删除。
中科优品推荐
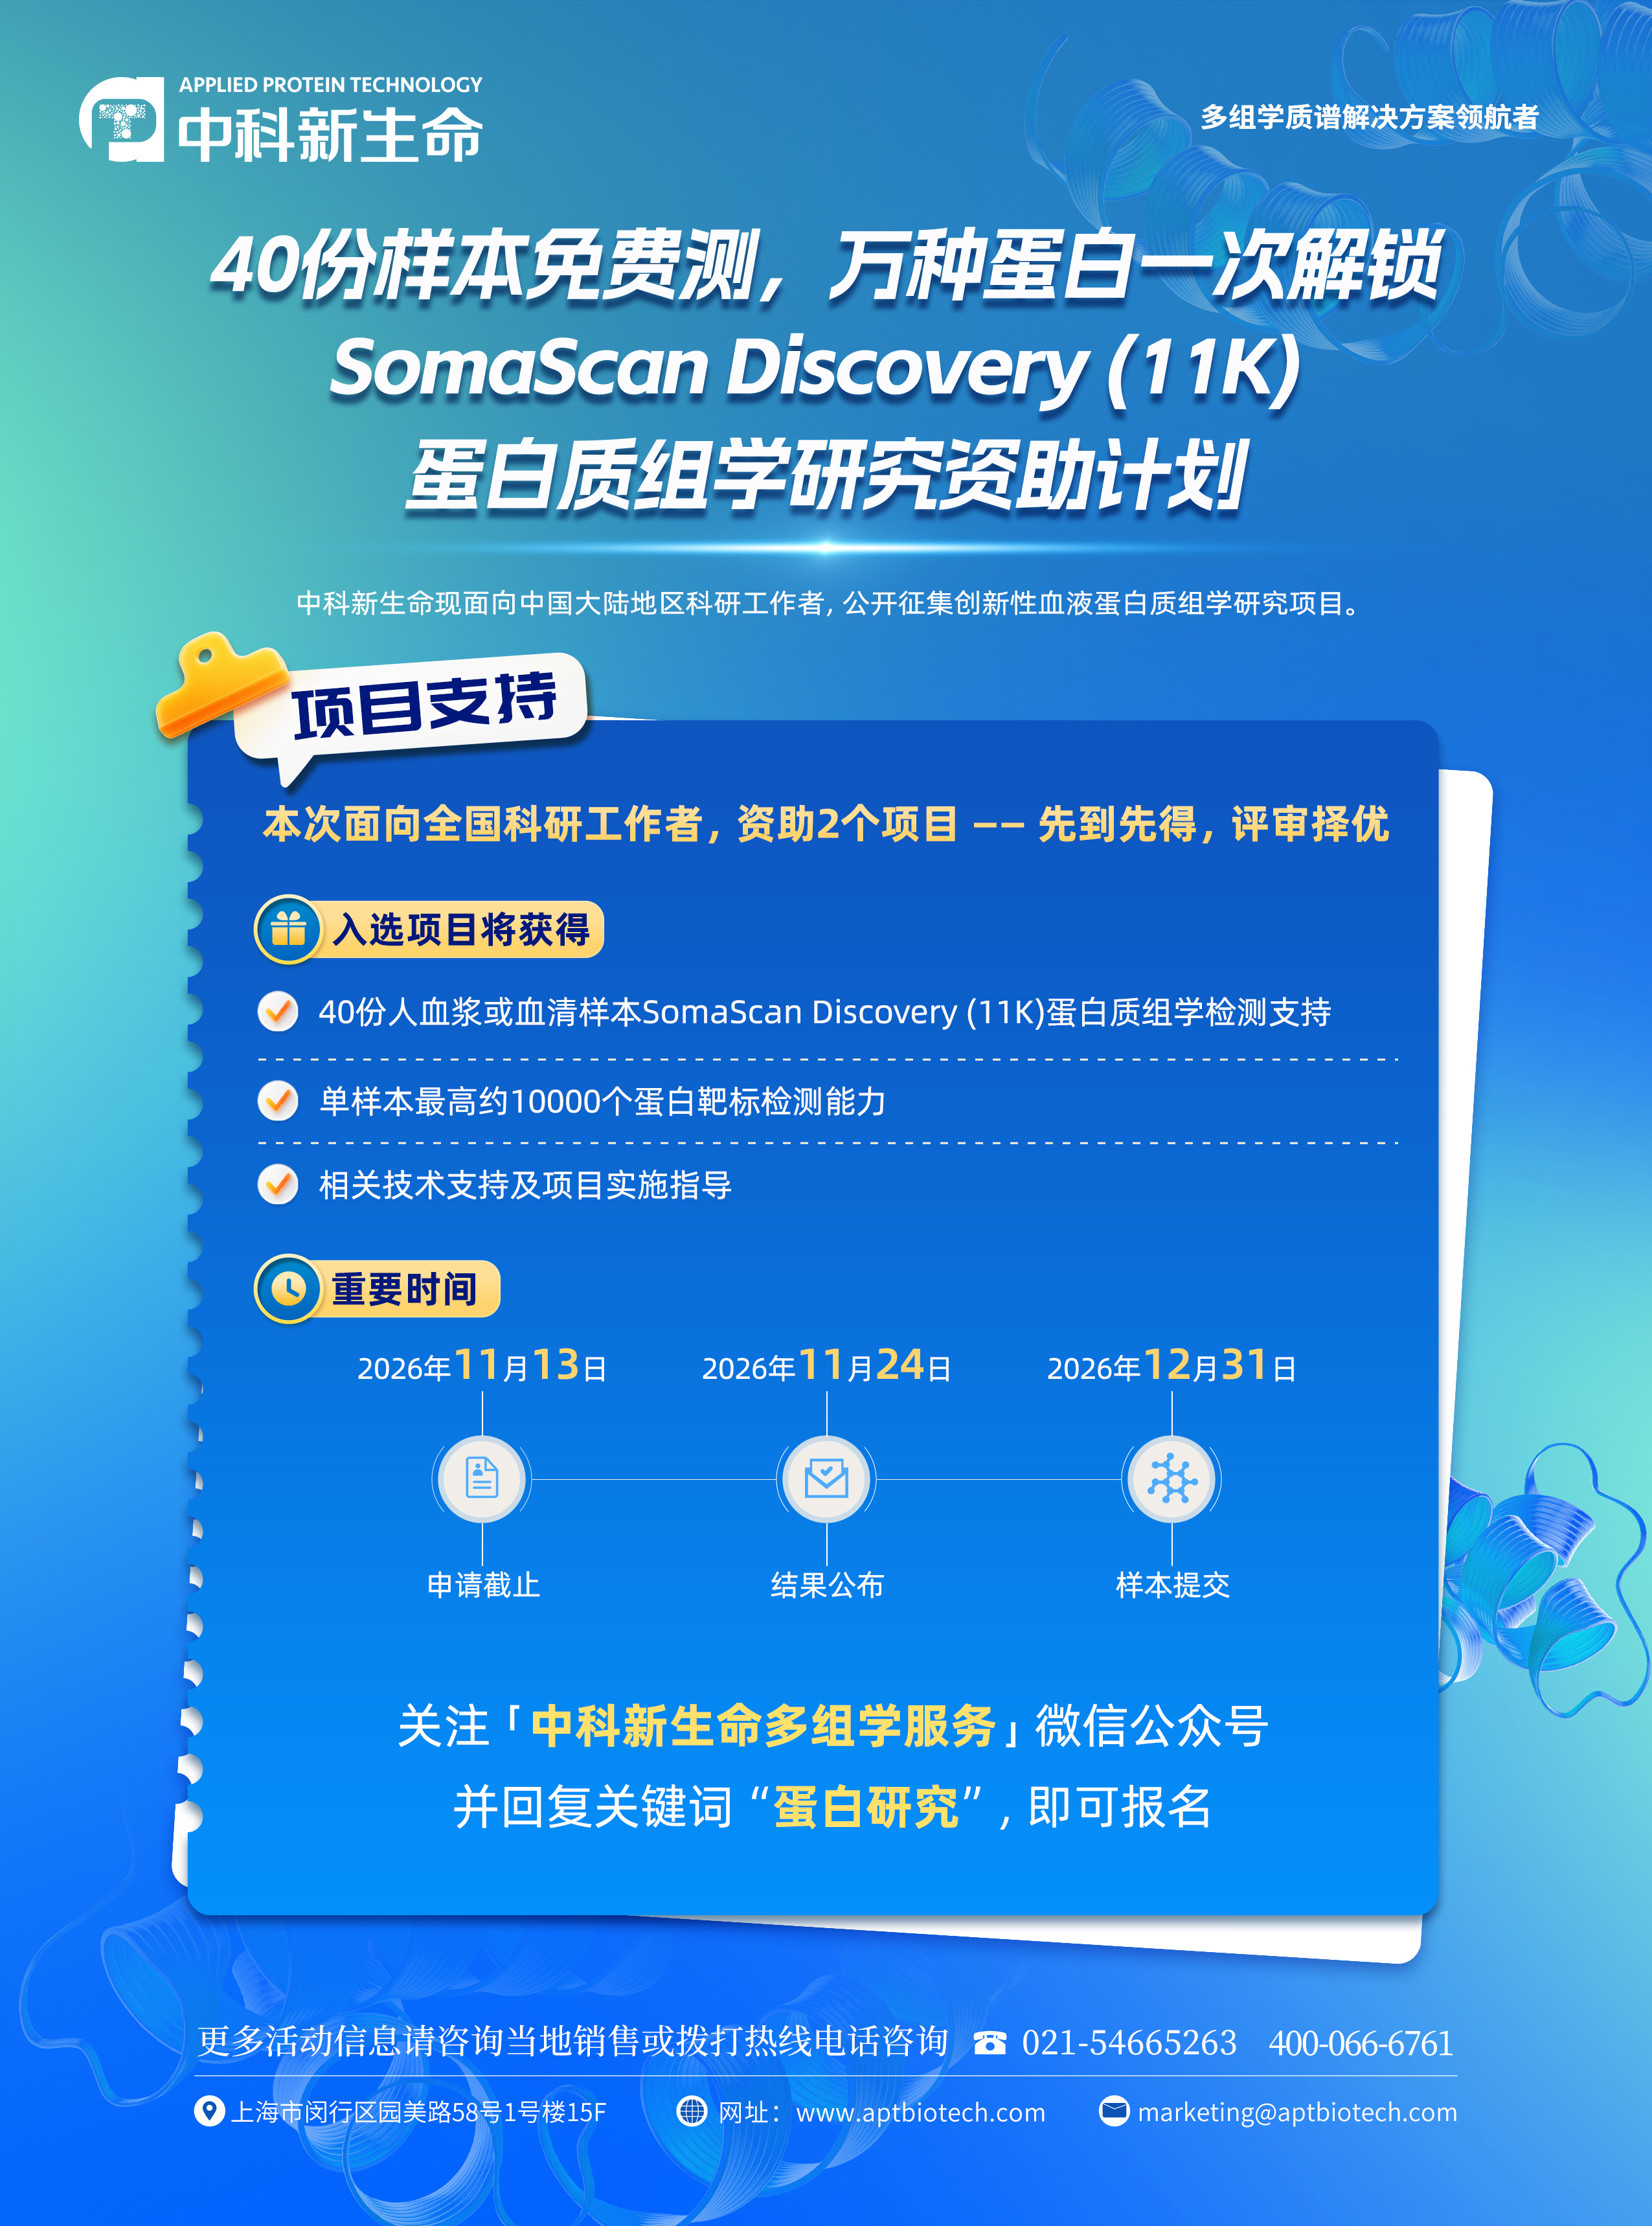
【SomaScan免费测】中科新生命 2026 蛋白质组学研究资助计划重启!关注“中科新生命多组学服务”微信公众号,回复关键词“蛋白研究”报名,80 例 SomaScan Discovery (11K)样本免费测,做血液蛋白组、标志物发现、队列研究的同行别错过!!!
关于中科新生命
上海中科新生命生物科技有限公司(APTBIO)创立于 2004 年,由原中国科学院上海生命科学研究院蛋白质组研究中心孵化而来,是国内质谱多组学应用领域的开拓者。公司以 “AI + 质谱多组学” 双核驱动创新,构建智能化组学生态。拥有自主知识产权的质谱检测平台与 AI 大数据分析系统,聚焦科技服务、生物医药及大健康消费三大领域,为全球科研机构、医院、药企提供从基础研究到临床转化的一站式解决方案。融合多组学技术与人工智能,围绕生物标志物发掘、药物靶点筛选及个性化诊疗等方向,构建具有国际竞争力的组学数据库与算法模型,推动转化医学进程,加速创新药物研发,成为推动生命科学数字化升级的核心引领者。